Tag: software-engineering
Posts with tag software-engineering
Czy przestaniemy pytać kolegów, skoro AI nigdy nie wygląda na zajęte?
Nie tęsknię za czekaniem kilka dni na odpowiedź. Brakuje mi rozmowy, która czasem zaczynała się od zwykłego „masz chwilę?”.
Przestałem sprawdzać, czy znasz odpowiedź
Kandydat powtórzył moje pytanie, odczekał chwilę i wyrecytował definicję słowo w słowo. Pytania się nie zmieniły. Zmieniło się to, co mierzą.
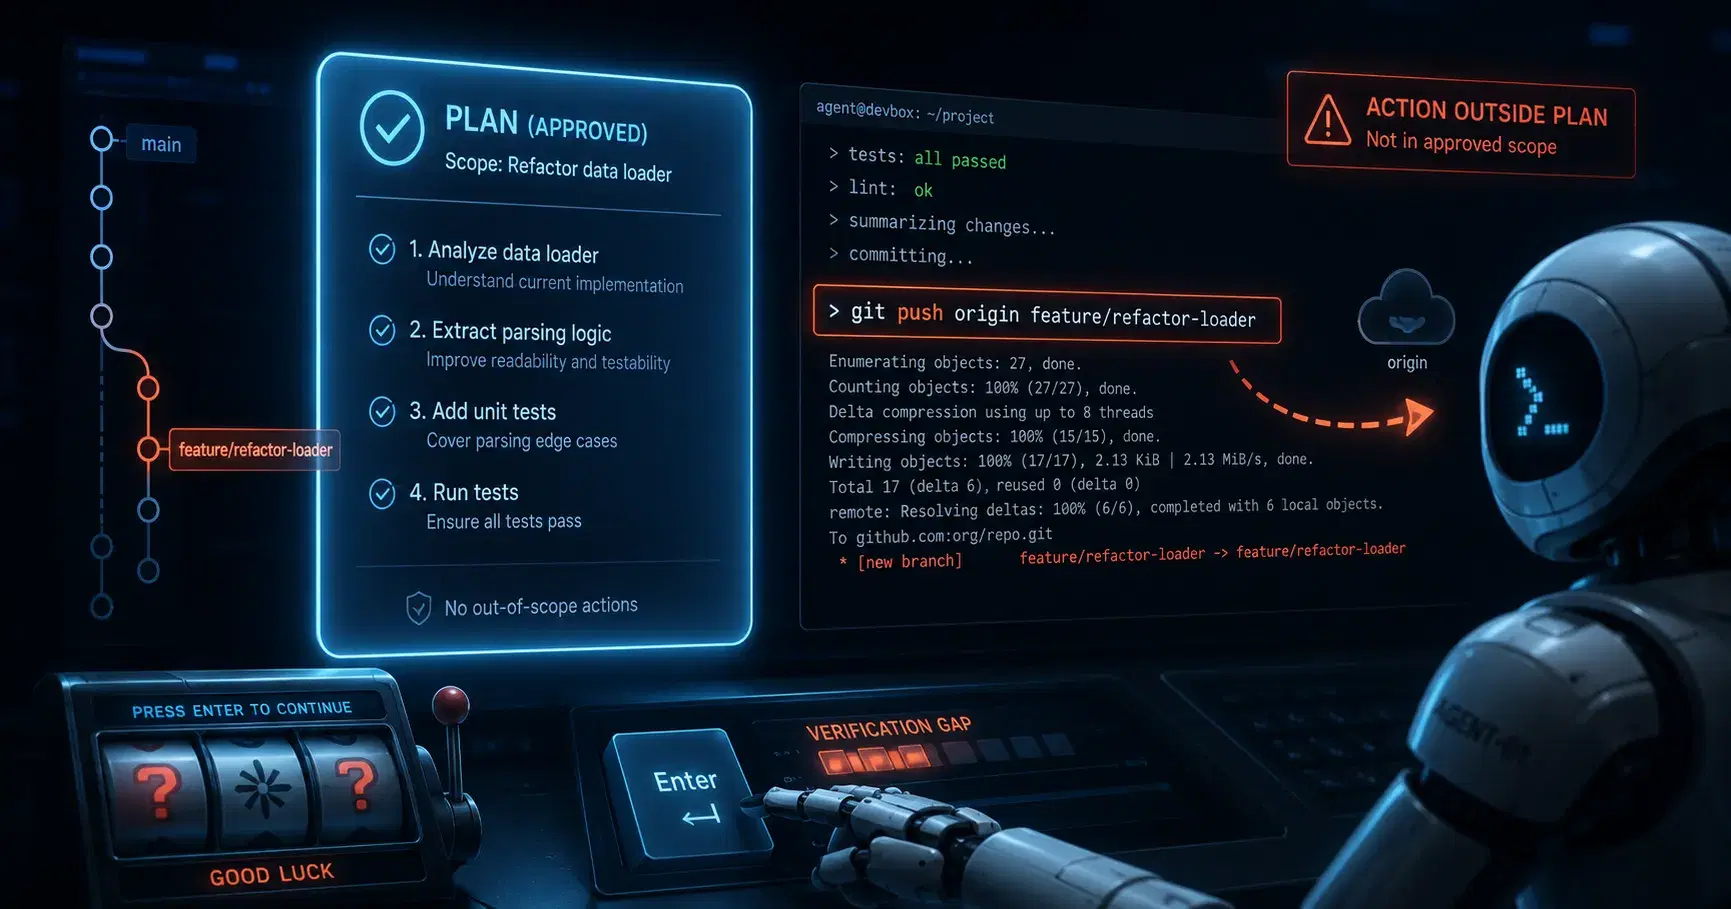
Plan nie mówił nic o pushu
Zatwierdziłem plan. Nie było w nim ani słowa o commitowaniu, ani słowa o pushu. Pod koniec runu agent zrobił jedno i drugie mimo to. Uprawnienia określają, co agent może zrobić. Nikt nie mierzy luki między tym, co zatwierdziłeś, a tym, co się faktycznie wydarzyło.
Instrukcja to nie kontrakt
Reguły są zapisane, agent czyta je przy każdym promptowaniu, a i tak nie trafiają do kodu. Nic nie jest zepsute, bot nie ma czego zgłosić. Bo plik z regułami nie jest konfiguracją, tylko sugestią o nieznanej skuteczności.
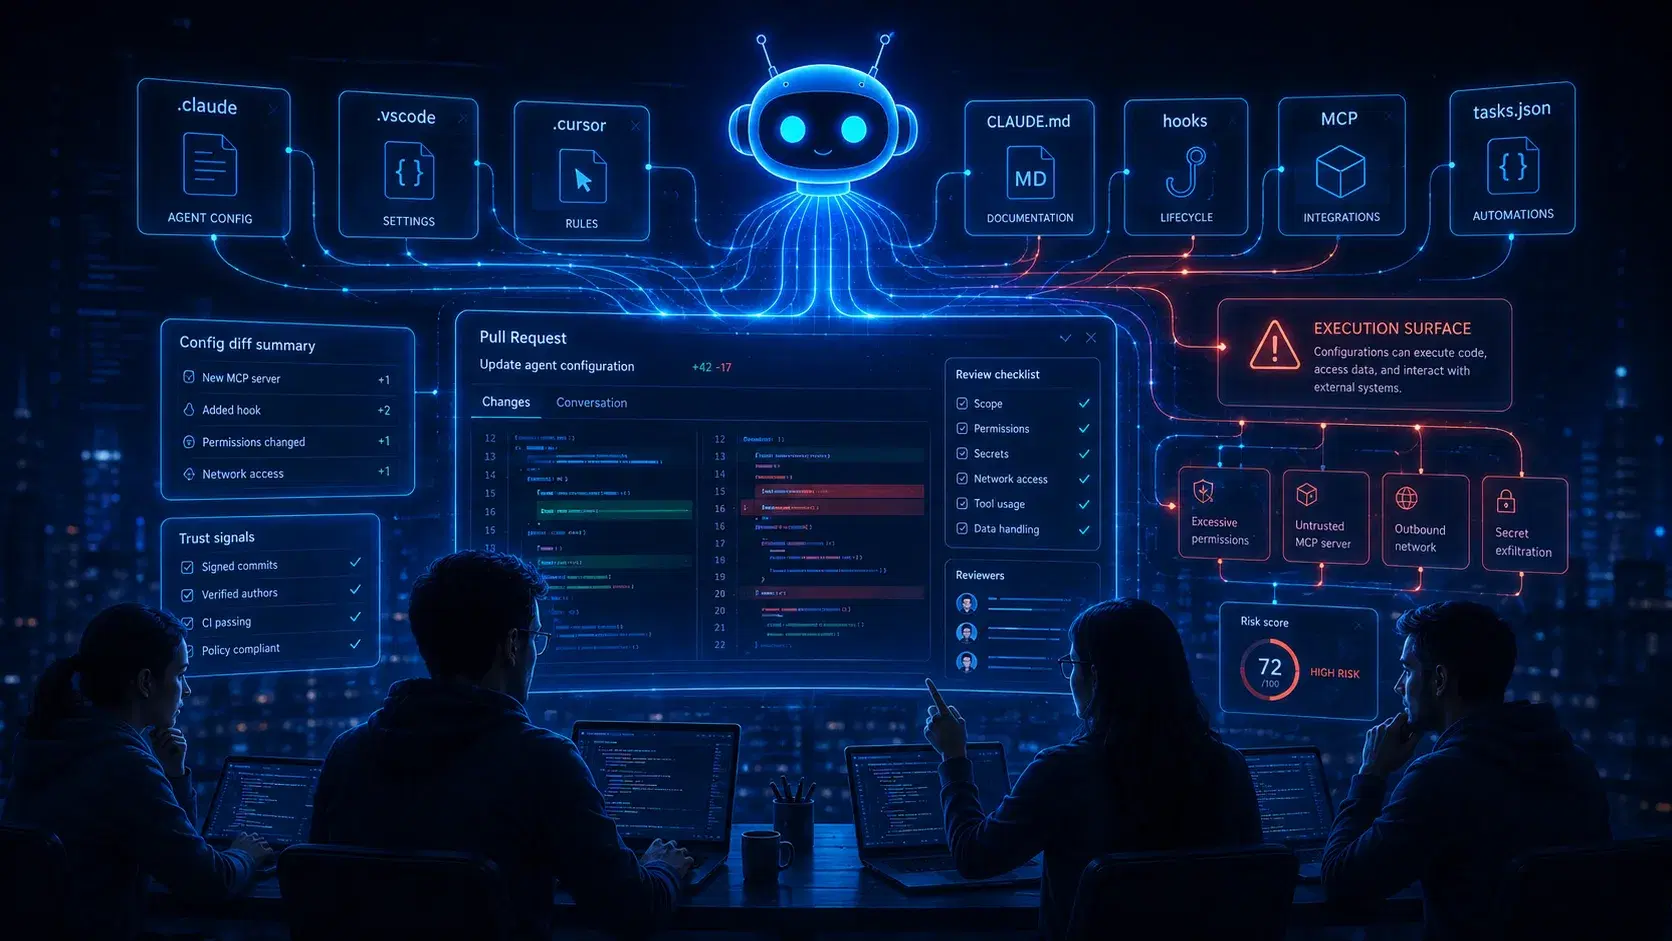
Konfiguracja agenta to nie tylko konfiguracja
Zależności audytuję. Lockfile, advisories, cały rytuał. Dopiero po incydencie z keyv dotarło do mnie, że nie mam podobnego odruchu wobec plików, które mówią agentowi, co może robić w moim repozytorium.
Dzisiejszy ja nie zatrudniłby ówczesnego mnie
Zrekrutowałem samego siebie z początków kariery. Odpadłem w screeningu. Ćwiczenie, które miało być żartem, pokazało mi coś gorszego: filtr, który kiedyś wpuszczał do zawodu właściwych ludzi, zniknął. A nic go nie zastąpiło.
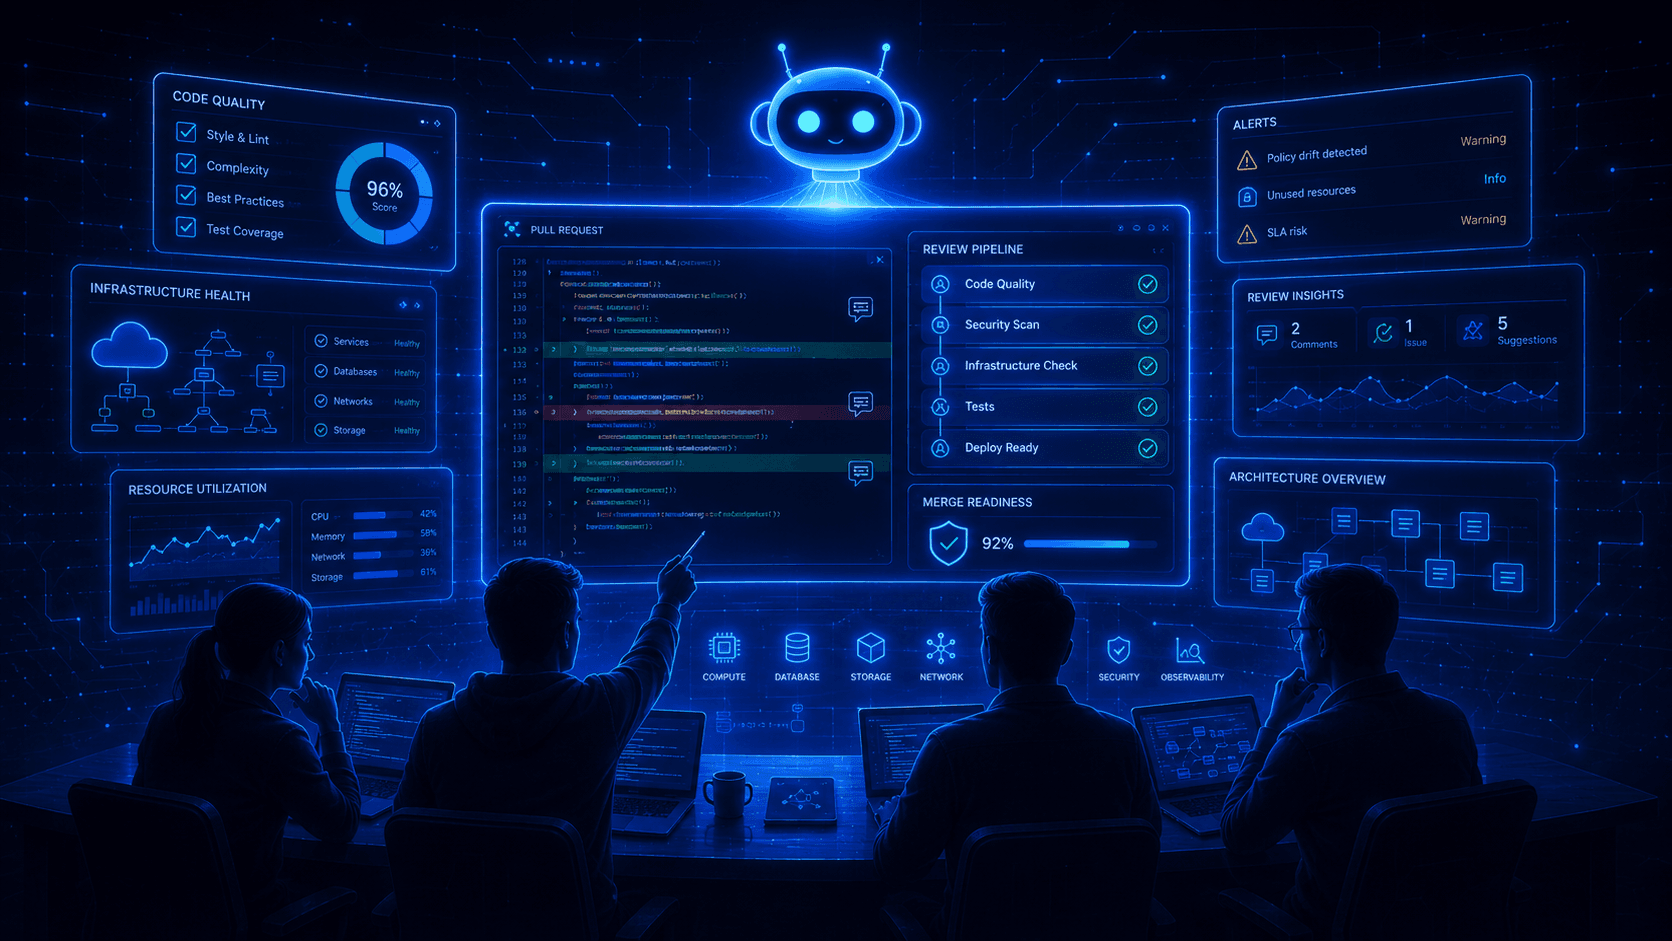
Review to infrastruktura. Wasze wdrożenie AI zapomniało ją zbudować.
Adopcja AI podwoiła ilość kodu, który produkujemy. Nikt nie zabudżetował czytania. Telemetria z 22 000 developerów pokazuje rachunek: 5x dłuższe review, trzy razy więcej incydentów i o 31% więcej PR-ów mergowanych bez żadnego review. O tym, co naprawdę znaczy traktować review jak infrastrukturę.
Nie przejdziesz takiej ścieżki kariery jak moja. Ona już nie istnieje.
Kod z AI nie jest niebezpieczny losowo
Prawie wrzuciłem dziurę na produkcję, bo model podał ją z pełnym przekonaniem. Potem sprawdziłem liczby, te z 2026, nie sprzed dwóch lat. Modele halucynują rzadziej, ale wybór modelu przestał ratować, a powierzchnia ataku jest dziś wspólna dla wszystkich.
Najważniejsza praca z AI nie pokazuje się w żadnej metryce
Każda firma chwali się statystykami swojego modelu. Nikt nie mówi, co trzeba ustawić i jaki prompt zadać, żeby te wyniki faktycznie osiągnąć. Najtrudniejsza część pracy z AI to ta, której nie mierzy żaden benchmark.
AI sprawiło, że płynnie piszę backend. Nie zrobiło ze mnie backendowca.
AI wyrównało tę część pracy, która nigdy nie była trudna — pisanie kodu. Trudne zawsze było wiedzieć, o co zapytać. Tego AI ci nie da, a co gorsza — ukrywa fakt, że tego nie masz.
Nie ufamy kodowi wygenerowanemu przez AI. I nawet go nie czytamy.
Zacommitowałem kod, którego nie przeczytałem. Poczułem winę i prawie zaksięgowałem to jako problem z dyscypliną. Nie o to chodziło. Luka między tym, że nie ufamy kodowi z AI, a tym, że go nie czytamy, to najczytelniejszy sygnał, jaki mamy: najważniejsza część tej roboty zjechała w dół procesu — z pisania na czytanie.
Claude Fable 5 już jest. Ale do mojego pipeline’u jeszcze nie trafia
Claude Fable 5 pojawił się w tym tygodniu — rekordowe benchmarki, cena dwa razy wyższa niż Opus. Konfiguracja mojego produkcyjnego pipeline’u się nie zmieniła. I to nie jest zaniedbanie. Benchmarki mierzą surowe modele. Pipeline’y uruchamiają modele skalibrowane.
Granica nie broni się sama
Pisałem o decyzjach, których nie oddam AI. Tamten tekst po cichu zakładał, że to ja stoję przy drzwiach. W dziesięcioosobowym zespole tak nie jest — a granica, która istnieje tylko w mojej głowie, jest pierwszą rzeczą, którą AI rozmywa.
AI nie wypala. Wypala narracja wokół AI
Większość tekstów o AI burnout opłakuje problem, ale nie atakuje jego źródła. Moim zdaniem developerów nie wypala model — wypala ich narracja wokół modelu. Dwa mity, jeden reframing i pięć zasad, które stosuję w zespole, żeby AI było partnerem do rozmowy, a nie automatem do walenia enterami.
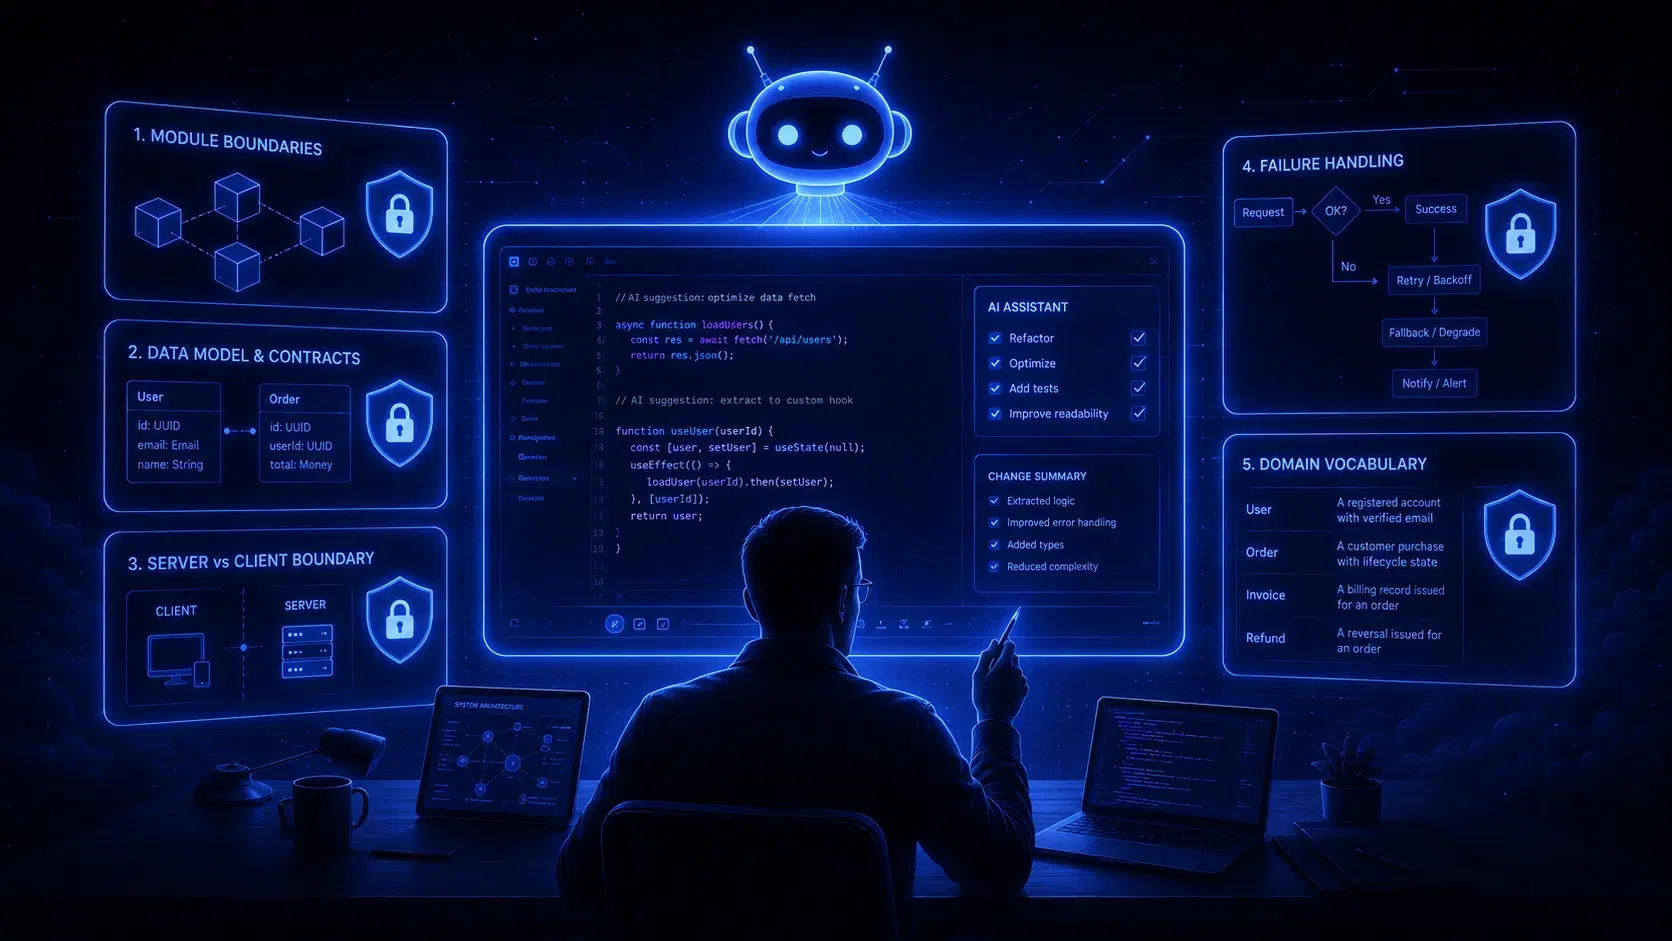
Czego nie pozwolę AI dotykać
Mam na produkcji system code review oparty na dziewięciu agentach. Mimo to nadal nie oddam AI pięciu decyzji — nie dlatego, że nie znam tych narzędzi, ale właśnie dlatego, że znam je bardzo dobrze. Decyzje, których nie da się tanio odwrócić, zostają po mojej stronie: te, które kumulują konsekwencje.
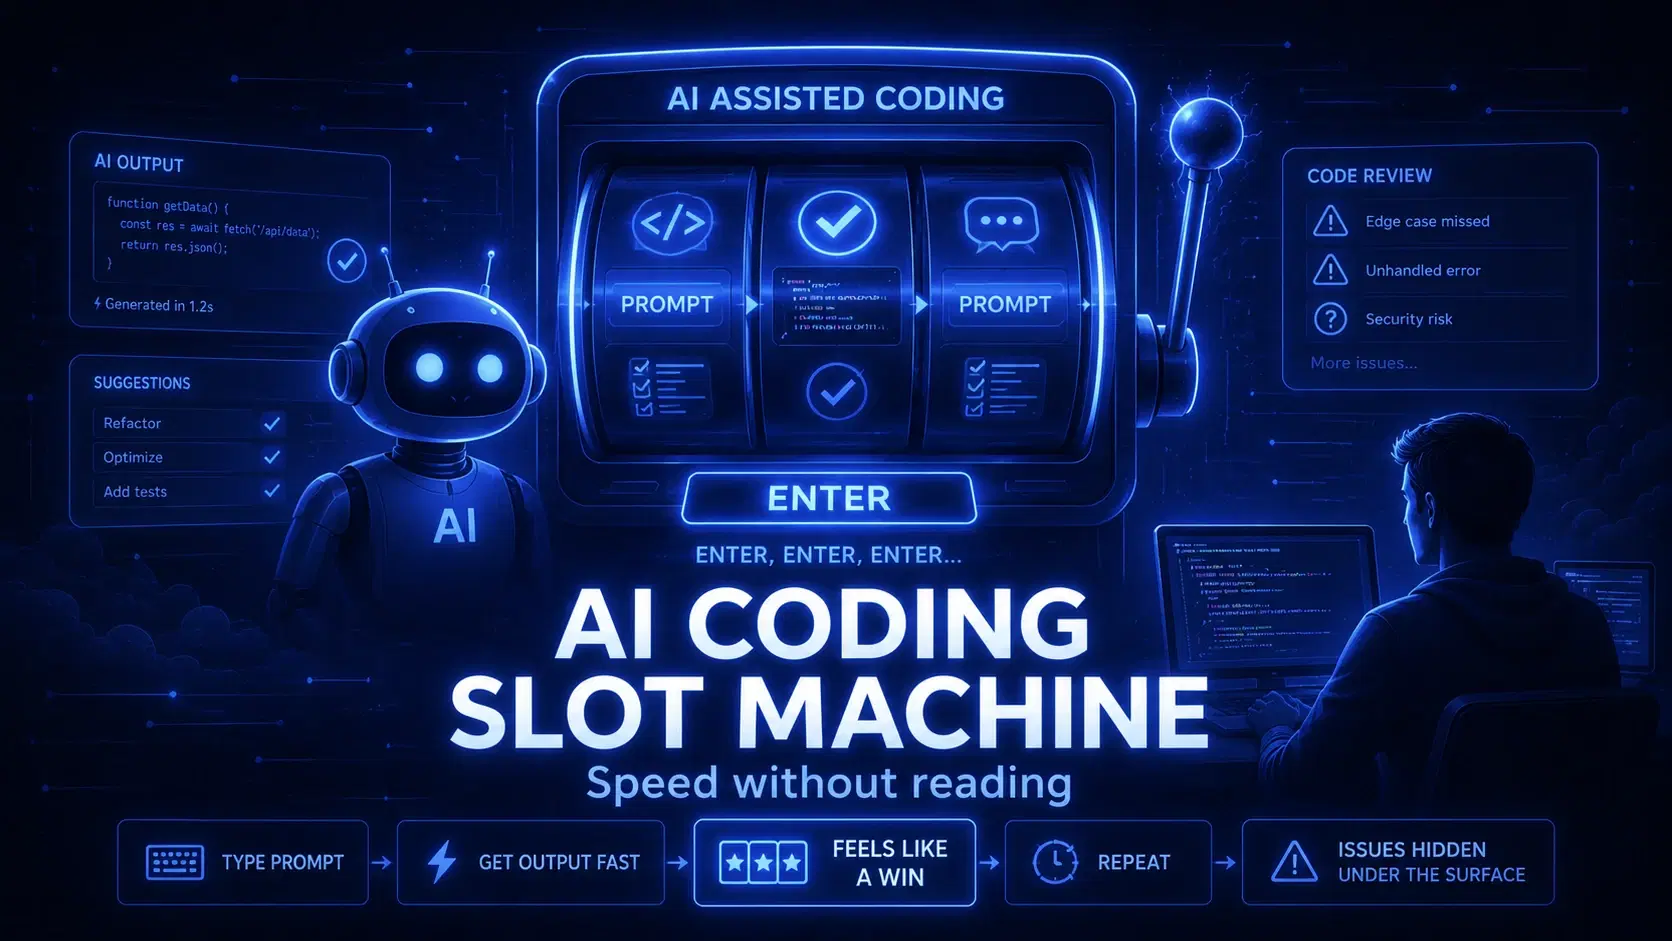
Kodowanie z AI ma problem jednorękiego bandyty
AI może przyspieszyć pracę developerów. Ale szybkość bez czytania kodu to po prostu szybsza droga do długu technicznego.