Czego nie pozwolę AI dotykać
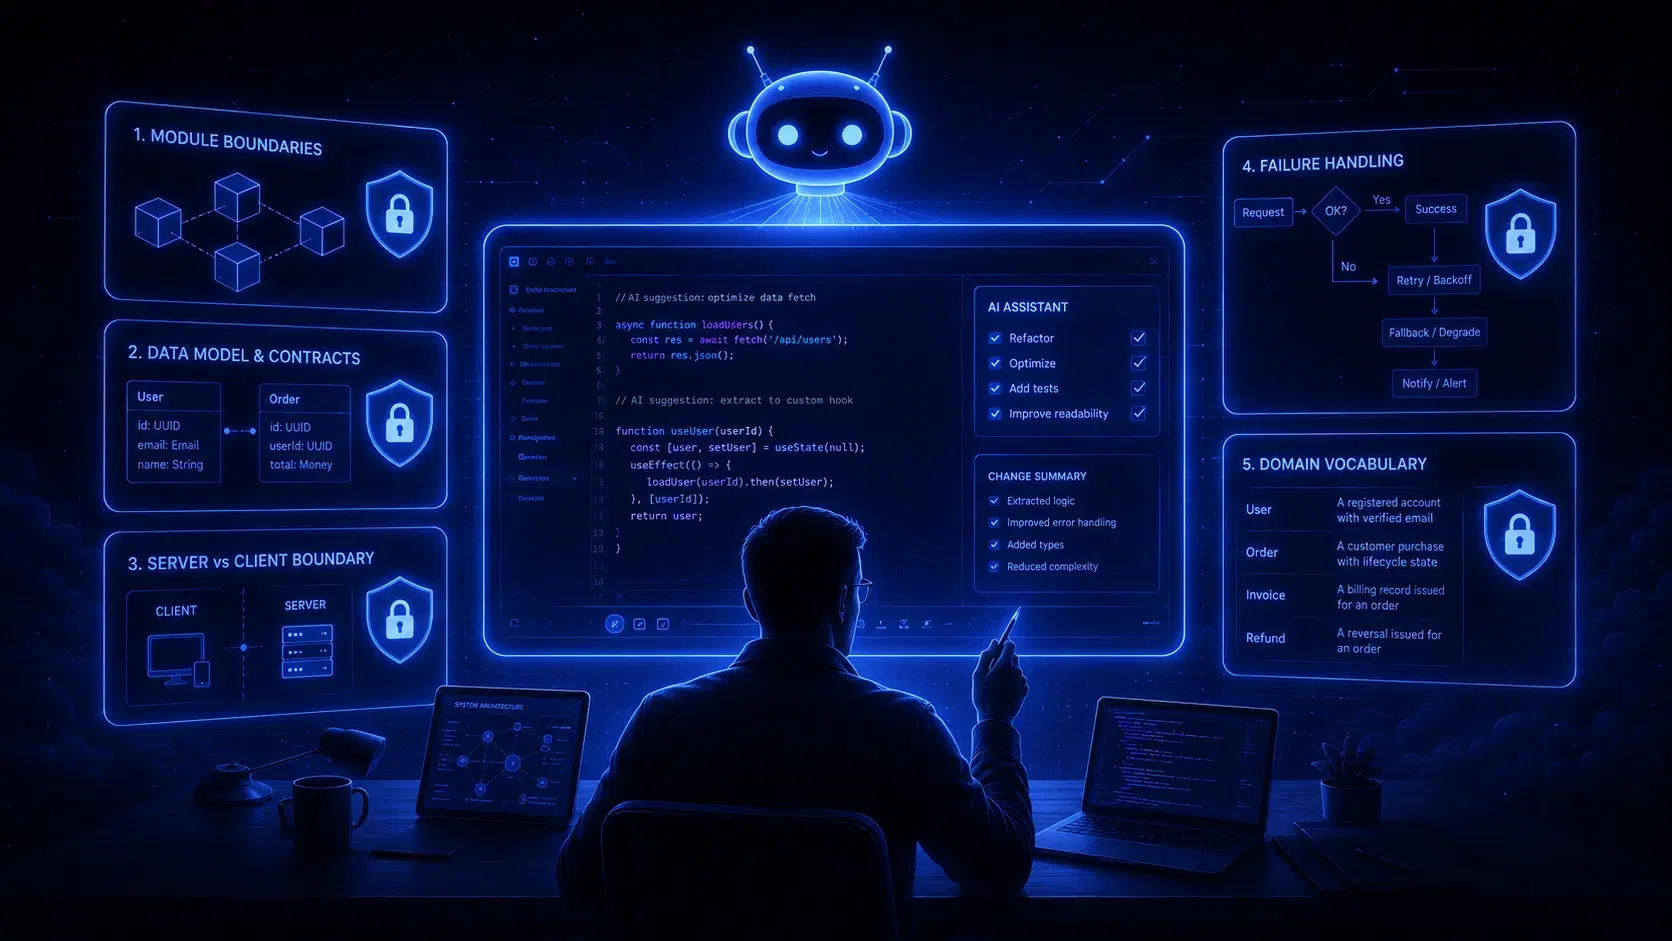
Mam na produkcji system code review oparty na dziewięciu agentach. Mimo to nadal nie oddam AI pięciu decyzji — nie dlatego, że nie znam tych narzędzi, ale właśnie dlatego, że znam je bardzo dobrze. Decyzje, których nie da się tanio odwrócić, zostają po mojej stronie: te, które kumulują konsekwencje.
Czego nie pozwolę AI dotykać
Mam na produkcji system code review oparty na dziewięciu agentach. Blisko 2 900 linii dopracowanych instrukcji, które analizują każdy pull request otwierany przez mój zespół. Patrząc rozsądnie, siedzę w tym naprawdę głęboko.
Więc kiedy mówię, że są decyzje, których nie oddam AI, warto dobrze to zrozumieć. To nie jest ostrożność ani brak wiary w te narzędzia. Wręcz przeciwnie. Doskonale wiem, w czym są dobre — i równie dobrze wiem, gdzie działa i jest właściwe przestają znaczyć to samo.
Pokażę ci, gdzie przebiega ta granica, na codebase, w którym stawka jest właściwie najniższa z możliwych: na moim własnym.
Zbudowałem tę stronę — code-nomad.com — samodzielnie, z AI działającym obok mnie na pełnych obrotach. Bez zespołu do koordynowania, bez klienta, bez użytkowników, którzy zauważą, jeśli coś będzie nie tak przez tydzień. A nawet tutaj AI dostarczyło mi komponent, który działał perfekcyjnie i jednocześnie był po cichu błędny. Pobierał treść bloga, sięgając bezpośrednio do systemu plików z poziomu komponentu prezentacyjnego — całkowicie omijając warstwę danych. Renderował się. Przechodził testy. Diff wyglądał czysto, bo każda linia z osobna była rozsądna. Problem nie był w żadnej pojedynczej linii. Problem był w kształcie całego rozwiązania.
Nikt nie miał tego wyłapać w review, bo żadnego review nie było — byłem tylko ja. Koszt pojawił się później, kiedy po raz pierwszy chciałem zmienić sposób ładowania postów i odkryłem, że logika rozlała się po trzech komponentach, z których każdy miał własną opinię na ten temat.
Jeśli ta granica istnieje nawet na prywatnym blogu bez użytkowników i bez regulatora, łatwo sobie wyobrazić, gdzie przebiega w pracy, która naprawdę trafia do ludzi. I właśnie tej różnicy szukam. Nie pytam: czy AI potrafi to napisać — bo prawie zawsze potrafi. Prawdziwe pytanie jest inne.
Jedyne pytanie, które naprawdę warto zadać
Jak drogo będzie to odwrócić, jeśli okaże się błędne?
Większość decyzji w codebase można cofnąć tanio. Wnętrze funkcji. Wybór stylowania. Struktura testu. Jeśli coś pójdzie źle, poprawiasz to — pięć minut pracy, bez koordynacji, bez wpływu na innych. To są drzwi dwustronne. Możesz przez nie przejść, rozejrzeć się i wrócić, jeśli coś ci nie pasuje.
AI jest świetne przy takich dwustronnych drzwiach. Pozwalam mu działać tam na pełnej prędkości i dzięki temu poruszam się szybciej.
Drzwi jednokierunkowe to zupełnie inna sprawa. Cofnięcie takiej decyzji nie jest edycją — to migracja, koszt koordynacji, czasem cichy rewrite, który zjada weekend, którego nikt nie planował. To są decyzje, które kumulują skutki: każda kolejna linia kodu zakłada, że były poprawne, więc koszt pomyłki rośnie z każdym commitem zbudowanym na ich podstawie.
Jest pięć takich obszarów, które zostawiam sobie. Przykłady poniżej pochodzą z tej strony — małej, niskiego ryzyka, mojej. Mechanizm jest identyczny przy każdej skali.
1. Granice modułów
AI optymalizuje plik, który ma przed sobą. To jednocześnie jego największa siła i ślepy punkt. Potrafi napisać czystą, poprawną zmianę wewnątrz granicy, którą mu wskażesz — ale nie widzi sprzężenia, które po cichu tworzy gdzie indziej, bo tego sprzężenia nie ma w jego kontekście.
Nie potrzebujesz monorepo, żeby się na tym potknąć. W pojedynczej aplikacji Next.js to już się dzieje: granica między warstwą danych, która czyta i parsuje mój Markdown, a komponentami, które go renderują. Granica to nie folder — to obietnica dotycząca tego, co może zależeć od czego. AI nie trzyma w głowie tej obietnicy. Trzyma w głowie zadanie. Sięga więc po import, który sprawia, że bieżący problem znika, komponent zaczyna czytać pliki bezpośrednio, a szew, który miał pozostać szczelny, zaczyna przeciekać przy następnym commicie.
Gdzie przebiega granica, co może przez nią przechodzić i co każda ze stron może zakładać — to zostaje po mojej stronie.
2. Model danych i jego kontrakty
Najczystszy przykład na tej stronie to rzecz, która znajduje się na samej górze
każdego posta: schemat frontmatter. title, excerpt, date, tags,
featuredImage. W momencie, w którym coś zaczyna zależeć od tego kształtu, jego
zmiana przestaje być edycją, a staje się migracją.
Zmiana nazwy jednego pola to nie jedna zmiana — to każdy plik posta używający starej nazwy, parser, który ją odczytuje, typy wyprowadzone z tego schematu, tagi OG i dane strukturalne zbudowane na jego podstawie, feed RSS. Wszystko musi przesunąć się naraz albo coś się rozsypie.
AI potrafi wymyślać struktury, które świetnie wyglądają w izolacji. Pole zagnieżdżone tam, gdzie jest wygodne dla tego komponentu, struktura ułożona pod ten ekran. Wygląda poprawnie, bo lokalnie jest poprawne. Potem przecieka do wszystkiego, co zaczyna się do niej dopasowywać — i okazuje się, że fundament został wylany, zanim ktokolwiek zdecydował, co właściwie budujemy. Model i kontrakty zbudowane na jego bazie to jedne z najwolniej zmienialnych elementów systemu. Ustalam je, zanim AI napisze przeciwko nim choćby jedną linię.
3. Granica między serwerem a klientem
W App Routerze to jest ta decyzja architektoniczna, a jednocześnie bardzo łatwo ją przeoczyć. To, co działa na serwerze, i to, co trafia do klienta, nie jest tylko optymalizacją wydajności. To decyzja o tym, co pobiera przeglądarka, co zostaje zaindeksowane i gdzie żyją twoje dane.
Ta strona bardzo konkretnie pokazała mi to napięcie, bo używam GSAP do animacji,
a GSAP działa tylko po stronie klienta. Najprostsza droga to wrzucić
"use client" na górę strony, żeby jedna animacja zaczęła działać — i w ten
sposób przeciągnąć całe poddrzewo na klienta, razem z treścią bloga, którą
specjalnie chciałeś renderować po stronie serwera, żeby ładowała się szybko i
dobrze indeksowała. AI wybiera tę drogę za każdym razem. Gdy stoi przed wyborem,
bierze to, co pozwoli komponentowi się skompilować i wyrenderować, a
"use client" jest bardzo łatwe do wpisania. Granica przestaje być decyzją i
staje się przypadkiem.
Wolę, żeby była decyzją: wyspy animacji zostają po stronie klienta, treść zostaje na serwerze, a granica między nimi jest narysowana celowo.
4. Semantyka błędów
AI pięknie pisze happy path. Weźmy formularz kontaktowy na tej stronie — wysyła maile przez Resend. Poprosisz AI o coś takiego i dostaniesz czyste, czytelne, działające wywołanie dla scenariusza, w którym mail faktycznie wychodzi.
Prawdziwy projekt zaczyna się jednak na ścieżce błędu, a to właśnie tę część AI prawie zawsze opisuje zbyt płytko. Co widzi odwiedzający, gdy Resend nie działa albo request timeoutuje. Czy nieudana wysyłka wygląda identycznie jak udana — bo najgorsza wersja tego problemu to formularz, który mówi „dzięki, wiadomość wysłana!”, podczas gdy wiadomość nie poszła nigdzie. Czy podwójne kliknięcie wysyła wiadomość dwa razy. Tego nie ma w happy path, więc nie pojawi się, dopóki ktoś nie zdecyduje, że musi się pojawić.
Tym kimś jestem ja. Semantyka błędów nie jest dodatkiem, który dokleja się później — to decyzja podejmowana przed pierwszą linią kodu, bo happy path wygląda tak samo niezależnie od tego, czy ktoś pomyślał o awariach, czy nie. I właśnie dlatego to są drzwi jednokierunkowe: kiedy luka staje się widoczna, zwykle jest już na produkcji.
5. Język domeny
To najcichszy z tych obszarów i ten, którego skutki kumulują się najmocniej — i uczciwie przyznam, że na prywatnym blogu stawka jest mała. Ale mechanizm jest ten sam, który robi prawdziwe szkody w większych systemach, więc warto obserwować go nawet tutaj.
Każdy system jest zbudowany na zestawie słów. Na tej stronie są to teraz klucze
i18n — dodaję język polski i w momencie, w którym plik tłumaczeń zaczyna zależeć
od danego klucza, ten klucz staje się kontraktem. To także taksonomia tagów: czy
post ma tag ai, artificial-intelligence, czy machine-learning? Wybierz
jedno i trzymaj się znaczenia.
AI wymyśla synonimy. Potrafi nazwać ten sam koncept trzema różnymi słowami w
trzech plikach, każde lokalnie sensowne, a każdy taki synonim jest małym
pęknięciem we wspólnym języku. Jeden plik mówi ai, kolejny aiTools, trzeci
zapisuje klucz wiadomości trochę inaczej i polskie tłumaczenie po cichu spada z
powrotem na angielski. Pojawia się dryf, a odpowiedź na pytanie „czy te dwie
rzeczy oznaczają to samo?” ląduje zakopana w kodzie, który na poziomie każdego
pojedynczego commita wyglądał dobrze. Słownik jest mój do ustawienia i mój do
obrony. To najtańsza rzecz do zrobienia dobrze na początku i jedna z
najdroższych do naprawienia, gdy już się rozleje.
Co właściwie się zmieniło
AI przyspieszyło moją egzekucję. W moim zespole — powiedzmy trzykrotnie w tych obszarach, w których to wykonanie było wąskim gardłem.
Ludzie słyszą to jako trzy razy większy output. Ale nie o to chodzi. W praktyce oznacza to, że każda decyzja przychodzi trzy razy szybciej — również ta błędna. Zła granica kiedyś wchodziła do codebase przez tydzień, powoli, z takim tarciem, że można było ją po drodze zauważyć. Teraz ląduje w jedno popołudnie, czysta, przetestowana i błędna dokładnie w taki sposób, którego nie widać w diffie.
Prędkość nie zmienia tego, które drzwi są jednokierunkowe. Sprawia tylko, że docierasz do nich szybciej i z mniejszym oporem po drodze — co oznacza, że moment podjęcia decyzji jest dziś ważniejszy, a nie mniej ważny. Wcześniej chroniło nas to, że budowanie złej rzeczy trwało długo. Ta ochrona zniknęła.
Dlatego praca nie stała się łatwiejsza. Przesunęła się wyżej. Mniej mojego dnia idzie na samo pisanie kodu. Więcej na decydowanie, jaki kod w ogóle powinien istnieć, gdzie przebiegają granice i co system może zakładać — a potem na pozwalanie AI, żeby działało z pełną prędkością wewnątrz tych granic.
Tej części jeszcze nie da się delegować.
I nie jestem pewien, czy powinno się dać.
Czy ten wpis był pomocny?