Tag: code-review
Posts with tag code-review
Przestałem sprawdzać, czy znasz odpowiedź
Kandydat powtórzył moje pytanie, odczekał chwilę i wyrecytował definicję słowo w słowo. Pytania się nie zmieniły. Zmieniło się to, co mierzą.
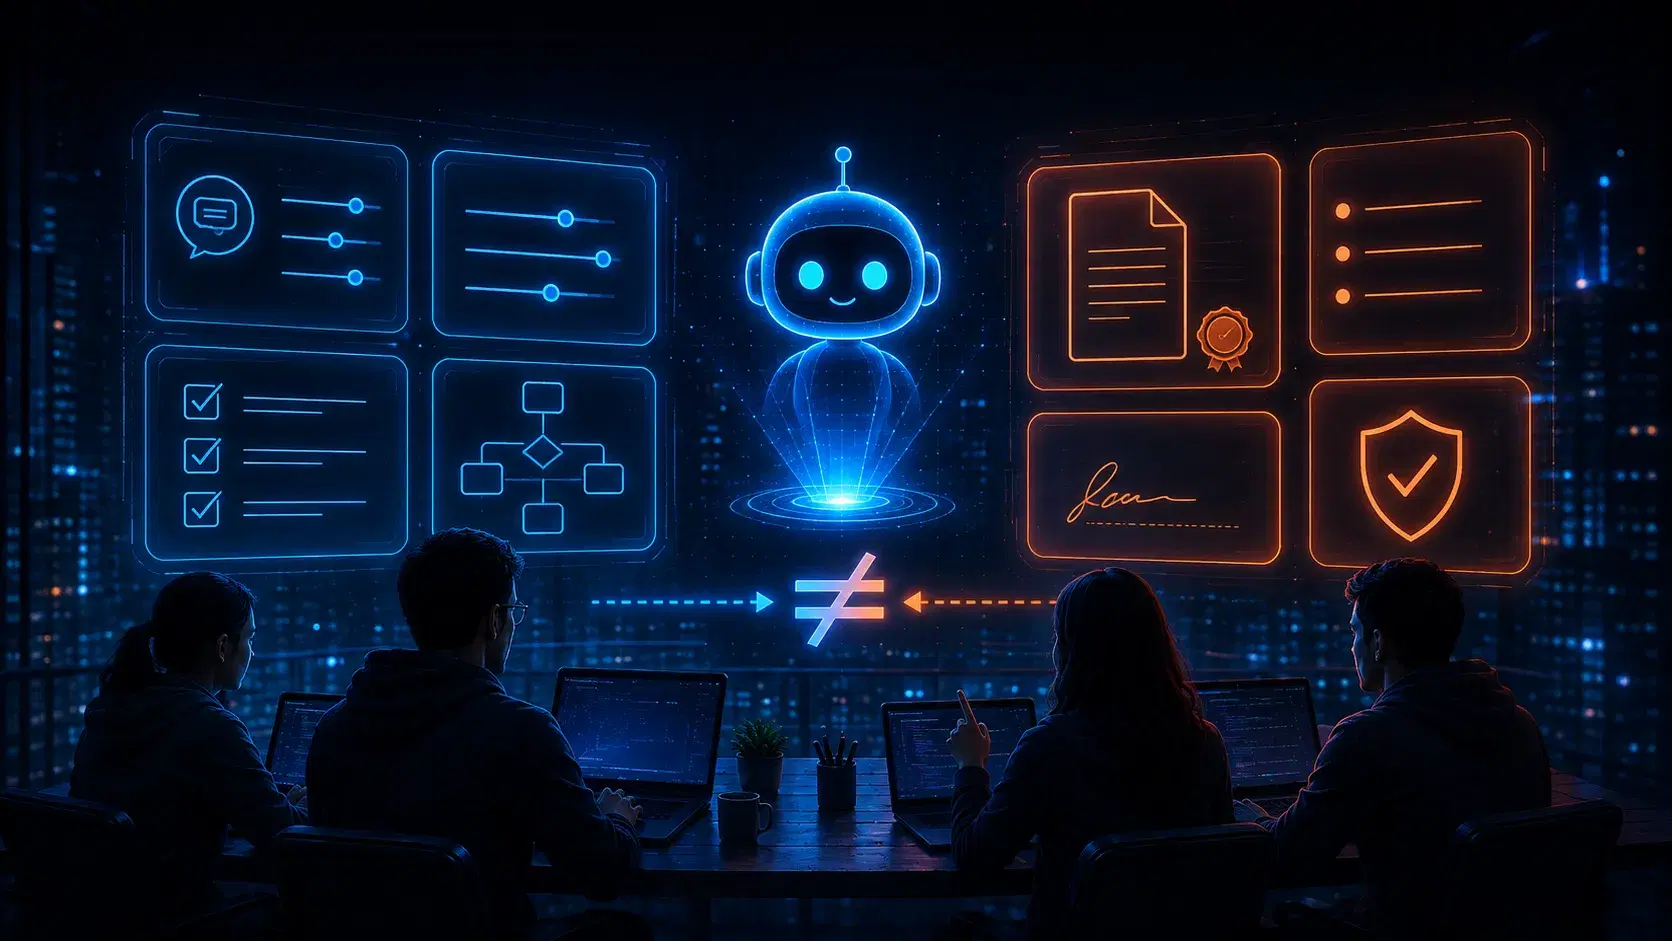
Instrukcja to nie kontrakt
Reguły są zapisane, agent czyta je przy każdym promptowaniu, a i tak nie trafiają do kodu. Nic nie jest zepsute, bot nie ma czego zgłosić. Bo plik z regułami nie jest konfiguracją, tylko sugestią o nieznanej skuteczności.
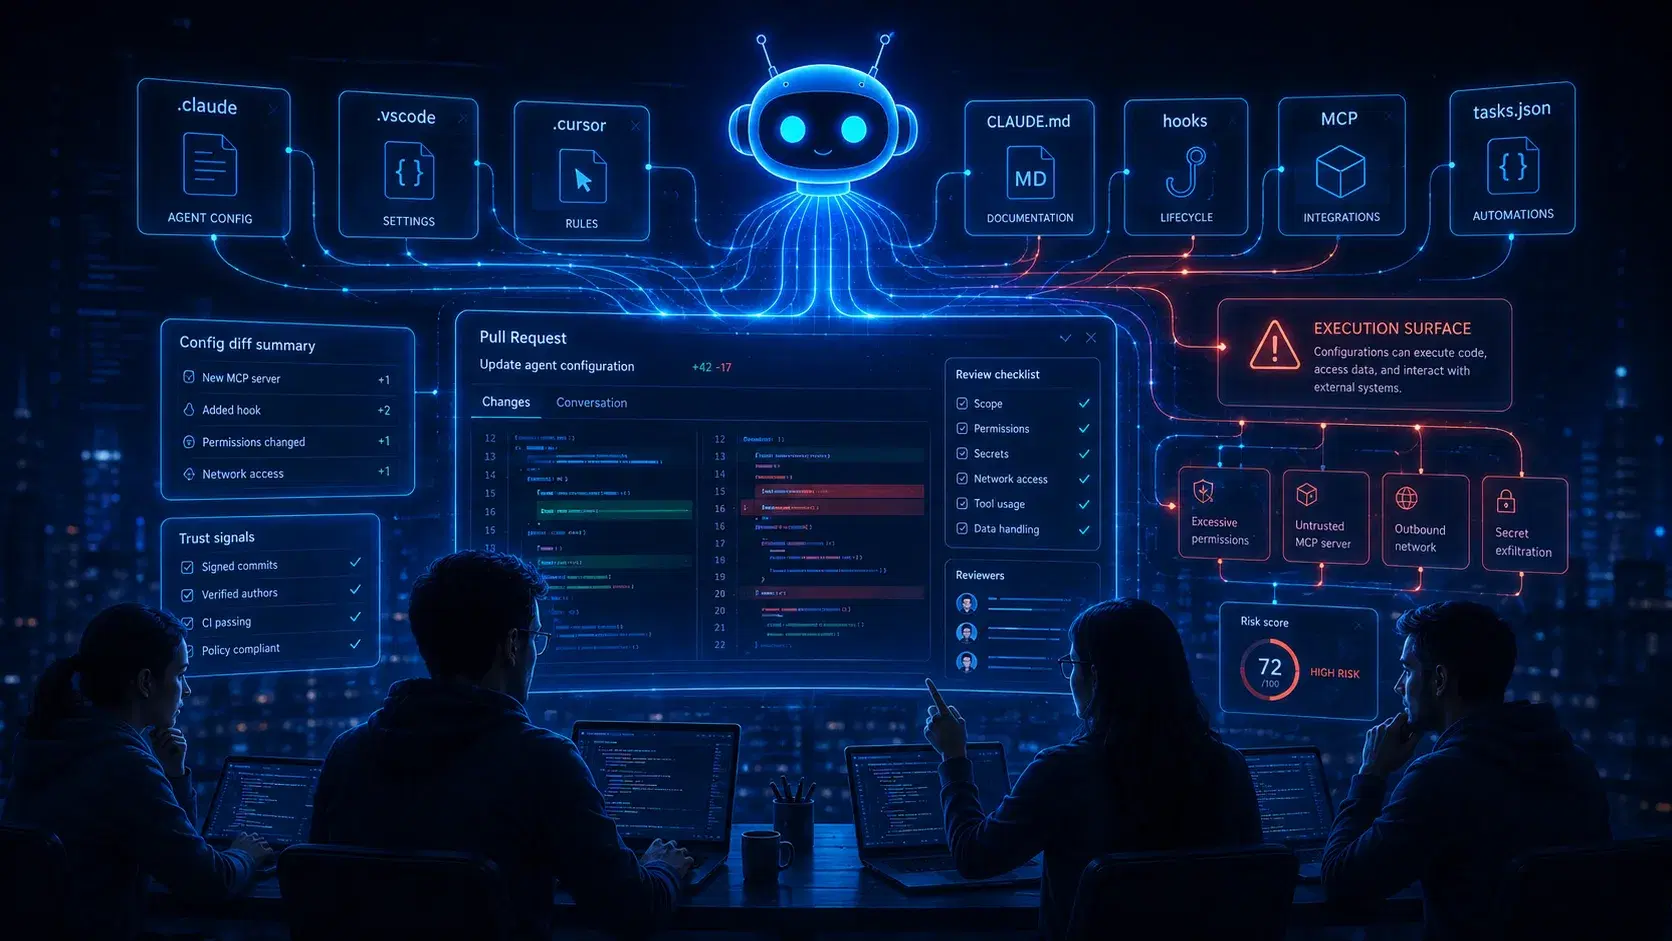
Konfiguracja agenta to nie tylko konfiguracja
Zależności audytuję. Lockfile, advisories, cały rytuał. Dopiero po incydencie z keyv dotarło do mnie, że nie mam podobnego odruchu wobec plików, które mówią agentowi, co może robić w moim repozytorium.
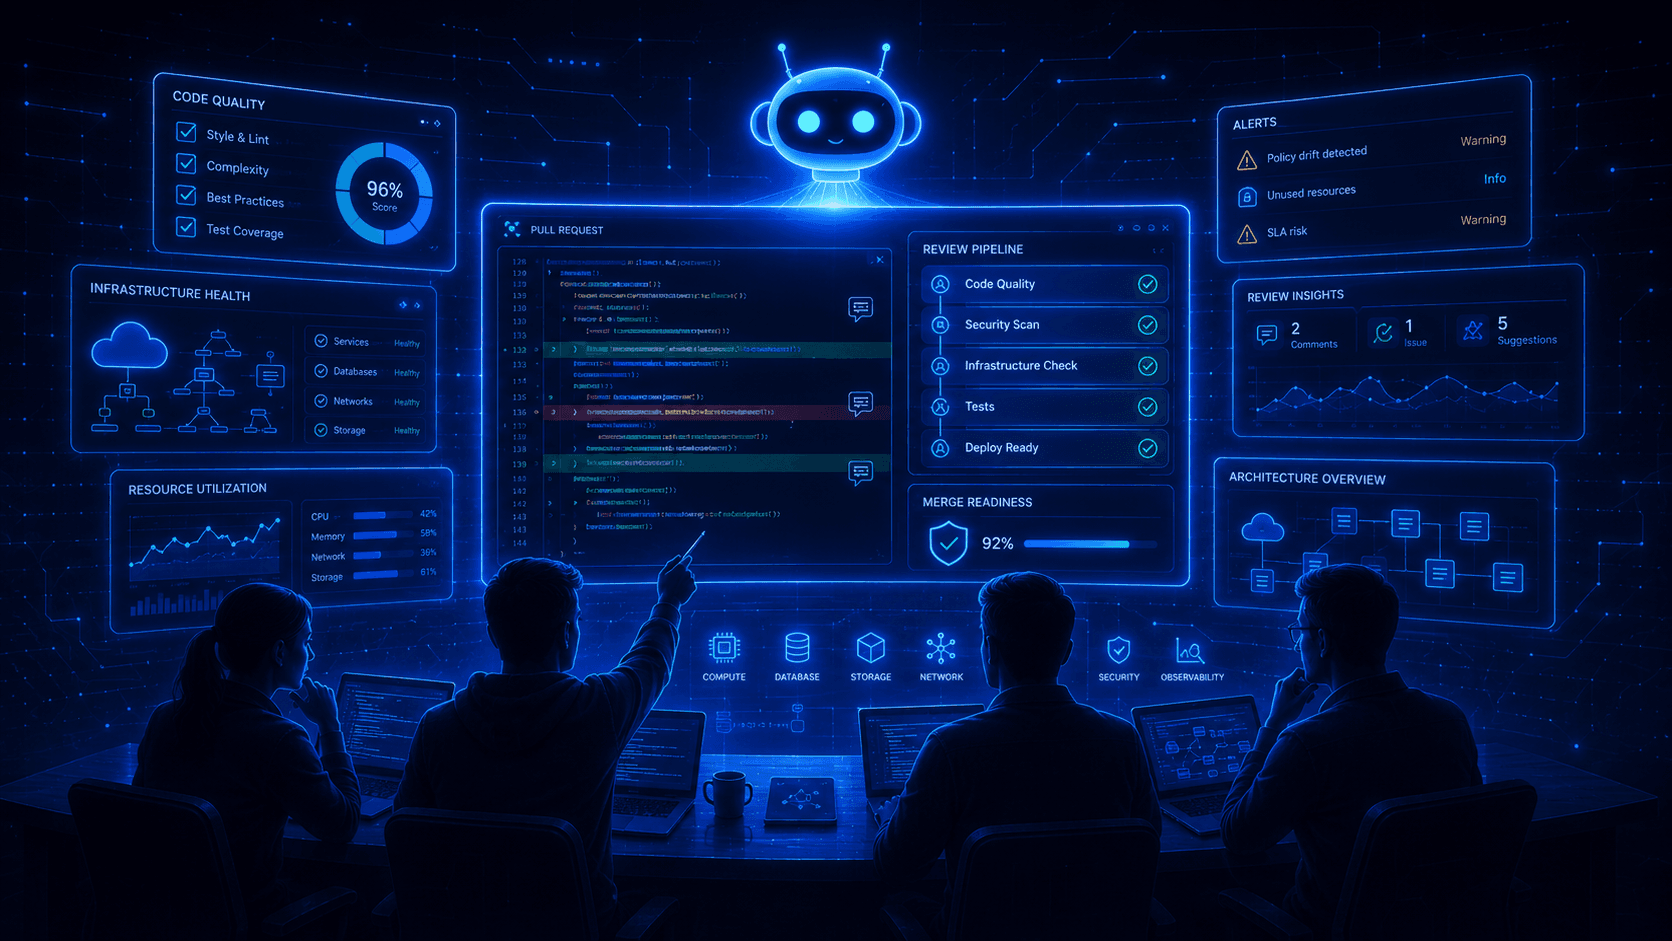
Review to infrastruktura. Wasze wdrożenie AI zapomniało ją zbudować.
Adopcja AI podwoiła ilość kodu, który produkujemy. Nikt nie zabudżetował czytania. Telemetria z 22 000 developerów pokazuje rachunek: 5x dłuższe review, trzy razy więcej incydentów i o 31% więcej PR-ów mergowanych bez żadnego review. O tym, co naprawdę znaczy traktować review jak infrastrukturę.
Nie ufamy kodowi wygenerowanemu przez AI. I nawet go nie czytamy.
Zacommitowałem kod, którego nie przeczytałem. Poczułem winę i prawie zaksięgowałem to jako problem z dyscypliną. Nie o to chodziło. Luka między tym, że nie ufamy kodowi z AI, a tym, że go nie czytamy, to najczytelniejszy sygnał, jaki mamy: najważniejsza część tej roboty zjechała w dół procesu — z pisania na czytanie.
Na co naprawdę patrzę w frontendowym code review
Szybkie pisanie kodu bez czytania prowadzi do długu technicznego. Oto rzeczy, które faktycznie sprawdzam w frontendowym code review przy dużych wolumenach danych — i miejsca, w których AI najczęściej się myli.
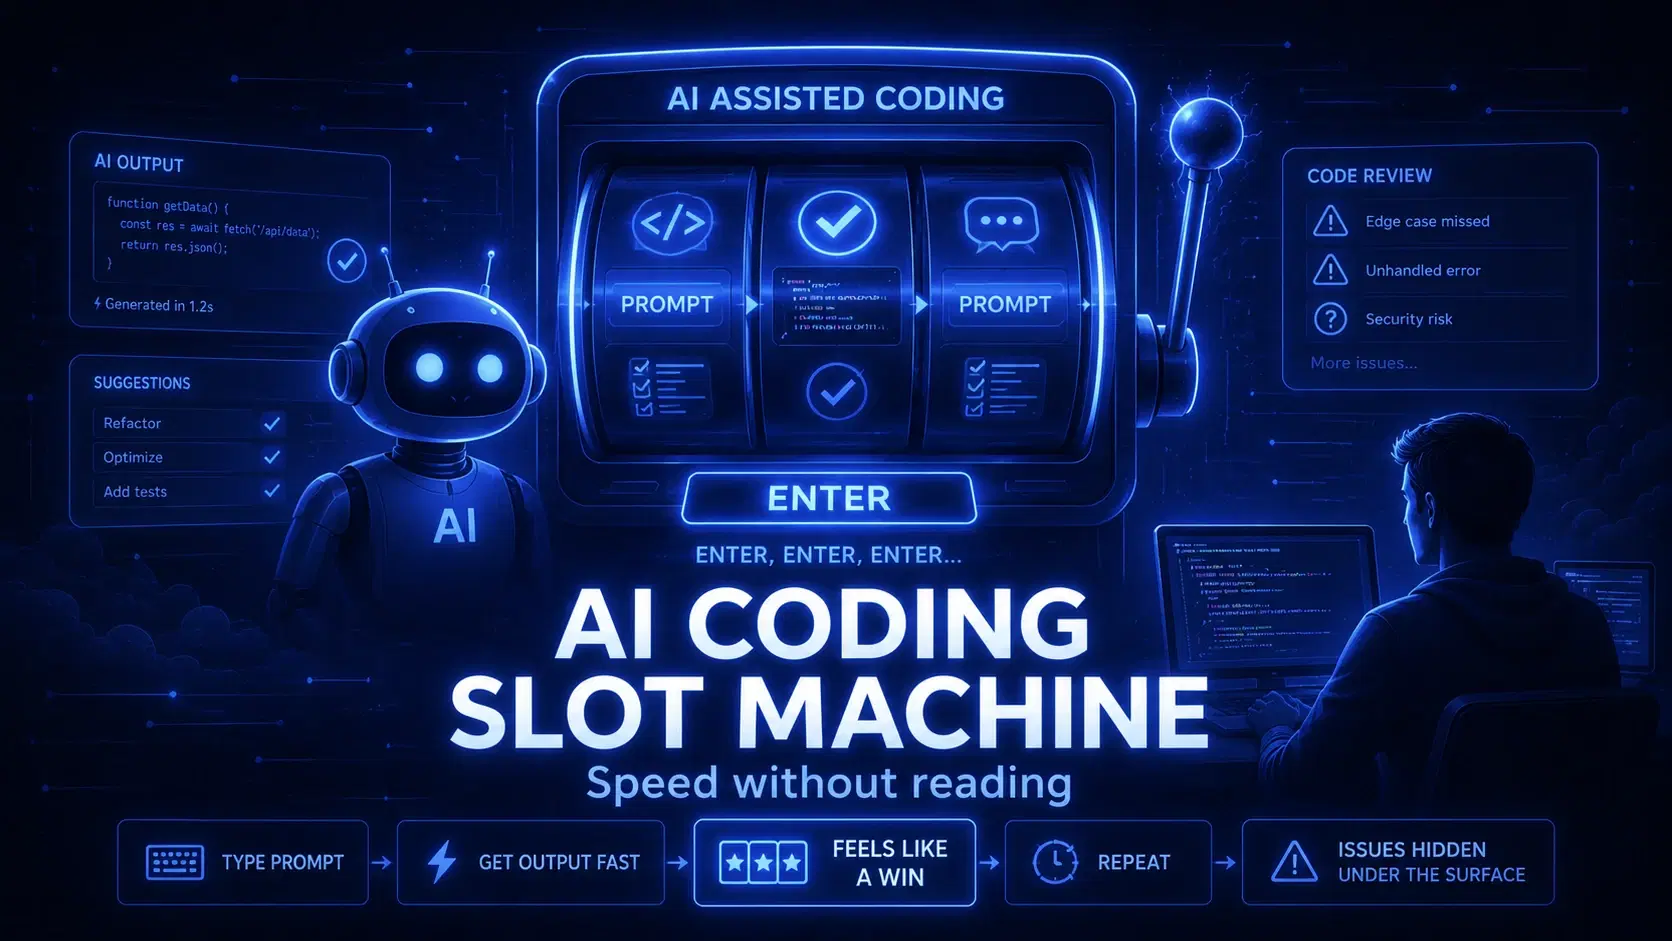
Kodowanie z AI ma problem jednorękiego bandyty
AI może przyspieszyć pracę developerów. Ale szybkość bez czytania kodu to po prostu szybsza droga do długu technicznego.
AI vs analiza statyczna — kiedy używać czego i po co używać obu
Komentarz pod ostatnim wpisem dał mi do myślenia: gdzie kończy się AI, a zaczyna analiza statyczna? Tak rysuję tę granicę — na podstawie systemu, którego używam na produkcji.
How I scale my AI code review system — and why every agent thinks like me
Adding a new agent to my system takes 2 days. Not because of the architecture — but because teaching it to think like me is the hard part.
Jak zbudowałem system AI code review z 9 agentami — używając samego Markdowna
Bez Pythona, bez Node.js, bez customowych pluginów. Tylko ~2 900 linii prompt engineeringu, architektura fan-out/fan-in i system, który naprawdę łapie realne bugi.