Czego AI nie nauczy juniora
AI może wygenerować kod, wyjaśnić wzorzec i przyspieszyć proste zadania. Nie nauczy jednak juniora czytać obcego kodu, kwestionować własnych decyzji ani rozumieć problemu zanim zacznie go rozwiązywać. Te lekcje kiedyś przychodziły przy okazji. Teraz trzeba je świadomie zaprojektować.
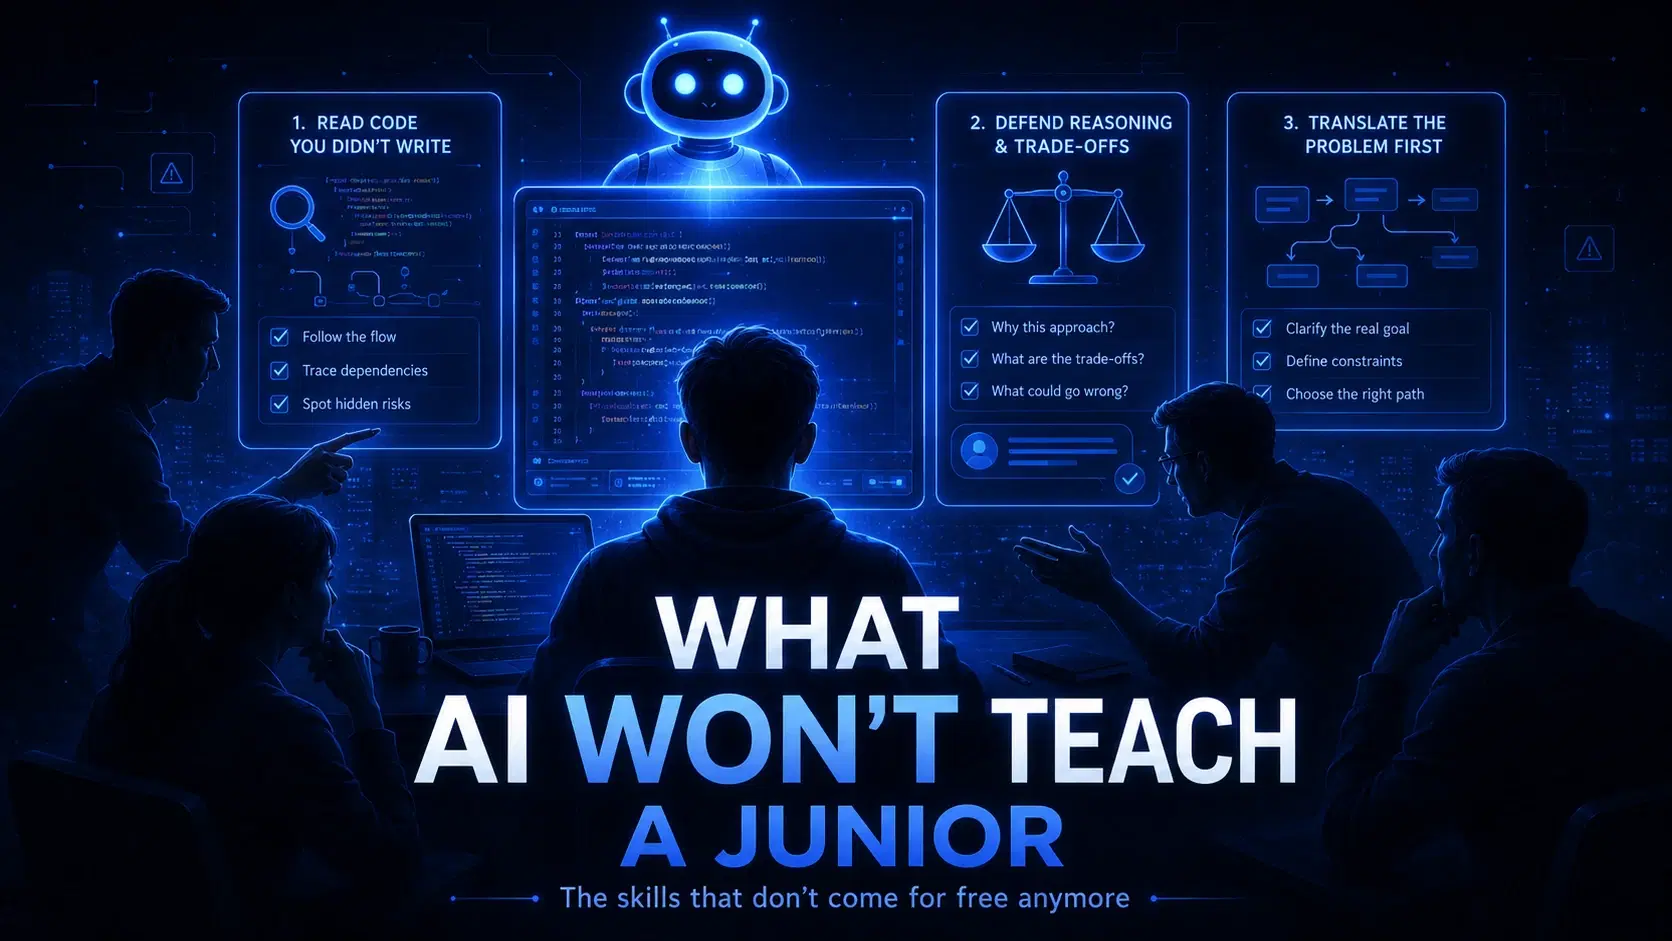
Czego AI nie nauczy juniora
Część 2 z 3 — seria o mentorowaniu juniorów w erze AI
W pierwszej części pisałem, że AI nie zabiło roli juniora. Zabiło jego pas startowy.
Mechaniczne zadania, na których juniorzy kiedyś się uczyli — boilerplate, CRUD, proste integracje — nadal istnieją, ale nie mają już tej samej wartości edukacyjnej. Junior może dziś je dowieźć, nie płacąc przy tym ceny poznawczej, która kiedyś była w nie wbudowana.
Ten tekst jest właśnie o tym, co było częścią tej ceny.
Bo boilerplate nigdy nie był lekcją samą w sobie. Boilerplate był nośnikiem lekcji. A razem z nim przychodziły co najmniej trzy umiejętności, które kiedyś dostawało się niejako za darmo — i których AI nie nauczy juniora, niezależnie od tego, jak dobry stanie się model.
A dokładniej: AI może je wyjaśnić. Może nawet zasymulować ich fragmenty. Ale nie zmusi juniora do ich ćwiczenia tak, jak robił to stary sposób pracy.
Jeśli nie zaczniemy uczyć ich świadomie, juniorzy mogą ich w ogóle nie złapać.
1. Czytanie kodu, którego samemu się nie napisało
Pierwsza strata jest tą, którą najłatwiej przegapić, bo nie wygląda jak umiejętność. Wygląda jak nudny obowiązek.
Ale czytanie obcego kodu — naprawdę czytanie, a nie tylko szybkie skanowanie — to sposób, w jaki developerzy budują sobie w głowie mapę systemu. Widzisz wtedy, jak codebase naprawdę się zachowuje, a nie jak twierdzi, że się zachowuje. Widzisz niedokończone abstrakcje. Widzisz obejścia, które ktoś zostawił z powodu, którego jeszcze nie rozumiesz.
Dawny junior nie mógł tego ominąć. Żeby dodać endpoint CRUD, musiał przeczytać pięć istniejących. Żeby naprawić małego buga, musiał prześledzić wywołanie funkcji przez trzy pliki. Nie wybierał czytania kodu — kod stał między nim a zadaniem.
Junior z AI często nie musi tego robić. AI czyta codebase za niego. AI podpowiada wzorzec. AI pisze diff. Junior czyta wynik. Może.
Ten mentalny mięsień — ten, który pozwala otworzyć nieznany plik i w minutę zbudować roboczą teorię tego, co on robi — szybko słabnie, kiedy przestaje się go używać.
I tu jest bolesna część: to jest też fundament sensownego code review.
Code review tak naprawdę nie polega tylko na sprawdzeniu, czy kod jest poprawny. Poprawność sprawdzą lintery i typy. Code review jest o tym, dlaczego ten wzorzec tutaj, a nie inny. O tym, czy wybór pasuje do logiki systemu. O tym, czy autor zrozumiał ograniczenia, czy tylko przypadkiem je spełnił.
Nie zrobisz takiego review, jeśli nie umiesz czytać kodu. A nie nauczysz się czytać kodu, patrząc tylko, jak AI go pisze.
2. Debugowanie czyjegoś rozumowania, nie tylko czyjegoś kodu
Moim zdaniem to jedna z najbardziej niedocenianych umiejętności w inżynierii oprogramowania.
Kiedy senior patrzy na pull request juniora i kod działa, senior nie kończy w tym miejscu. Pyta: dlaczego zrobiłeś to właśnie tak?
To pytanie nie jest czepialstwem. To jest sedno tej pracy.
Bo „działa” może znaczyć dwie zupełnie różne rzeczy. Czasem „działa” oznacza, że developer zrozumiał problem, rozważył alternatywy i wybrał właściwy kompromis. A czasem „działa” oznacza, że developer miał szczęście — test przeszedł, happy path działa, a kolejny bug już czeka, aż znajdzie go jakiś edge case.
Te dwa scenariusze wyglądają identycznie w diffie. Wyglądają identycznie w CI. Rozjeżdżają się dopiero pod presją — przy obciążeniu produkcyjnym, dziwnym inpucie albo refaktorze pół roku później.
Sposób, żeby je odróżnić, polega na sprawdzaniu rozumowania, nie samego kodu.
To właśnie seniorzy robią, często zupełnie nieświadomie, przy każdym review. Dlaczego taka struktura danych? Co się stanie, jeśli to będzie nullem? Czy rozważałeś odwrotne podejście? Co sprawiło, że zatrzymałeś się akurat tutaj?
Junior piszący własny kod miał przynajmniej jakieś rozumowanie, którego mógł bronić. Mogło być słabe, ale było jego. Można było przejść z nim przez miejsca, w których to rozumowanie się załamywało.
Junior dowożący kod wygenerowany przez AI często nie ma czego bronić. Kod się pojawił. Junior go zaakceptował. Jeśli zapytasz, dlaczego ten wzorzec, a nie inny, uczciwa odpowiedź brzmi: „nie wiem — tak mi wygenerowało”.
To nie jest lenistwo. To problem środowiska uczenia się. Nikt nie pokazał im, jak wziąć odpowiedzialność za kod, którego sami nie napisali — jak go sprawdzić, jak się z nim nie zgodzić, jak potraktować go jako hipotezę, a nie gotową odpowiedź.
Dopóki się tego nie nauczą, „działa” nadal będzie zbyt często oznaczać „udało się”.
3. Przetłumaczenie problemu, zanim zacznie się go rozwiązywać
Trzecia umiejętność jest najdalej od klawiatury — i właśnie w niej AI pomaga najgorzej.
AI świetnie radzi sobie z rozwiązywaniem jasno opisanego problemu. Trudniejsza, bardziej chaotyczna część naszej pracy polega na ustaleniu, czym ten problem właściwie jest.
Product manager mówi: potrzebujemy sposobu, żeby użytkownicy mogli eksportować swoje dane.
Senior słyszy w tym zdaniu pięć pytań. Którzy użytkownicy — wszyscy czy tylko wybrany segment? Jakie dane — te, które wprowadzili, czy też te, które wyliczamy? Eksport do czego — plik do pobrania, email, API? Jak często — jednorazowo, cyklicznie, na żądanie? I pytanie, które decyduje o wszystkim: po co im ten eksport i co później z nim zrobią?
Junior, który siedział już przy setce takich rozmów, usłyszy te same pytania. Junior, który nie miał tej ekspozycji, nie usłyszy ich. Weźmie zdanie dosłownie, poda je AI, dostanie przycisk do pobrania CSV i dowiezie coś, co technicznie pasuje do requestu, ale całkowicie rozmija się z sensem problemu.
Tego nie uczysz się przez pisanie większej ilości kodu. Uczysz się tego, siedząc obok ludzi, którzy potrafią zakwestionować request. Obserwując, jak rozmowa produktowa przechodzi od mglistej potrzeby do konkretnego kontraktu. Będąc w pokoju, kiedy inżynier pyta: jaki problem my właściwie rozwiązujemy? — i nagle wszyscy orientują się, że nikt tego nie wiedział.
Takie rozmowy kiedyś działy się wokół juniorów cały czas, bo juniorzy uczestniczyli w planningach, refinementach, incident review, retro. Nadal się dzieją — ale połączenie między „byciem w pokoju” a „robieniem pracy” zrobiło się słabsze. Jeśli praca polega głównie na wykonaniu pośredniczonym przez AI, to samo „bycie w pokoju” przestaje wydawać się kluczowe. A umiejętność, która tam rosła, przestaje rosnąć.
Co łączy te trzy rzeczy
Wybrałem te trzy umiejętności świadomie — i nie dlatego, że lista jest kompletna.
Wybrałem je, bo mają wspólną cechę, która dobrze tłumaczy cały problem.
Kiedyś dostawało się je za darmo.
Nie dało się napisać endpointu bez przeczytania pięciu innych. Nie dało się debugować ticketa bez wejścia komuś do głowy. Nie dało się dowieźć feature’a bez zapytania PM-a, co właściwie miał na myśli.
Boilerplate był rachunkiem. Te umiejętności były resztą, którą dostawało się z powrotem.
Ta ekonomia się skończyła. Rachunku już nie ma. Reszty też nie.
To oznacza, że wszystko, czego chcemy dziś nauczyć juniora, musimy uczyć celowo. Nie jako efekt uboczny dawania mu pracy. Jako świadomy element tego, jak prowadzimy zespół.
To inna praca dla tech leadów niż ta, na którą wielu z nas się pisało. Playbook mentoringu, który większość z nas odziedziczyła, zakładał, że sama praca wykona połowę nauczania. Już nie wykona.
To co właściwie z tym robimy?
Tutaj zaczyna się temat trzeciej części i nie będę próbował upychać jej w jednym akapicie. Ale kształt odpowiedzi widać już w tych trzech umiejętnościach.
Jeśli czytanie kodu, debugowanie rozumowania i tłumaczenie problemów są rzeczami, których AI nie nauczy, to właśnie wokół nich musimy projektować pracę. Nie tylko wokół deliverable’a. Wokół świadomej praktyki.
To znaczy, że zadania dla juniorów trzeba dobierać inaczej. Review ich PR-ów musi zadawać inne pytania. Sam sposób, w jaki pozwalamy im używać AI, potrzebuje struktury — bo to samo narzędzie może albo przyspieszyć naukę, albo wydrążyć ją od środka, w zależności od tego, jak je wprowadzimy.
Od jakiegoś czasu układam sobie sposób myślenia o tym — progresję, która pokazuje, jak relacja juniora z AI powinna zmieniać się w czasie i jaką rolę na każdym etapie powinien mieć mentor. O tym będzie kolejny tekst.
Na teraz najważniejszy wniosek jest prostszy i ostrzejszy:
Pas startowy zniknął. Darmowe lekcje zniknęły razem z nim. Jeśli chcemy juniorów, którzy potrafią czytać kod, bronić swojego rozumowania i zrozumieć problem, zanim zaczną go rozwiązywać, musimy uczyć tych rzeczy — a nie liczyć, że pojawią się same przy okazji dowożenia ticketów.
Juniorzy sobie poradzą. Nie są mniej zdolni niż my byliśmy.
Ale my musimy być lepszymi mentorami niż ci, których sami mieliśmy.
Bo stary model przyuczenia do zawodu uczył trochę sam z siebie.
Ten już nie będzie.
Następny tekst w serii: czteroetapowy model pracy z AI jako junior — i rola mentora na każdym z tych etapów.
Czy ten wpis był pomocny?