Myliłem się co do Haiku
Używałem jednego modelu do wszystkiego i kiedy zużycie zaczęło rosnąć, obwiniałem plan. Rozwiązaniem okazało się rozdzielenie pracy, a największa oszczędność wcale nie wynikała z ceny tokenów.
Przez długi czas powtarzałem, że Haiku jest bezużyteczne.
Miałem ku temu powód. Wszystko, co mu zlecałem, wracało zbyt powierzchowne, więc w pewnym momencie po prostu przestałem go używać. Jeden model do wszystkiego, przez cały dzień.
Potem moje zużycie w planie Pro zaczęło rosnąć i zrobiłem dokładnie to, co pewnie zrobiłoby wiele osób. Uznałem, że problemem jest plan, sprawdziłem cenę wyższego pakietu i stwierdziłem, że nie chcę za niego płacić.
I właśnie ta decyzja okazała się najbardziej wartościowa, tylko z zupełnie innego powodu, niż zakładałem.
Zamiast zwiększać limit, musiałem sprawdzić, czy problem rzeczywiście leży w planie, czy może w sposobie, w jaki korzystam z modeli.
Robiłem to już wcześniej w pracy
Co ciekawe, podobny problem miałem już rozwiązany w projekcie dla klienta. Po prostu wcześniej nie patrzyłem na niego w ten sposób.
Większość pracy nad zadaniem wcale nie polega na podejmowaniu trudnych decyzji.
Zanim powstanie choć jedna linia kodu, ktoś musi odpowiedzieć na kilka dość nudnych pytań:
- Których plików dotyczy zmiana?
- Jak nazywane są podobne rzeczy w tej części projektu?
- Czy istnieje już implementacja, na której warto się oprzeć?
- Gdzie znajdują się testy i z jakiego frameworka korzystają?
To głównie wyszukiwanie informacji i ich podsumowanie. Nie potrzeba tutaj szczególnie skomplikowanego rozumowania.
Jednocześnie właśnie ten etap potrafi po cichu zużyć ogromną część kontekstu, bo żeby zrobić go dobrze, trzeba przeczytać sporo plików, które ostatecznie okażą się nieistotne.
Dlatego nie ma większego sensu wykonywać tej pracy w tym samym kontekście, w którym później podejmowane są właściwe decyzje.
Podział pracy
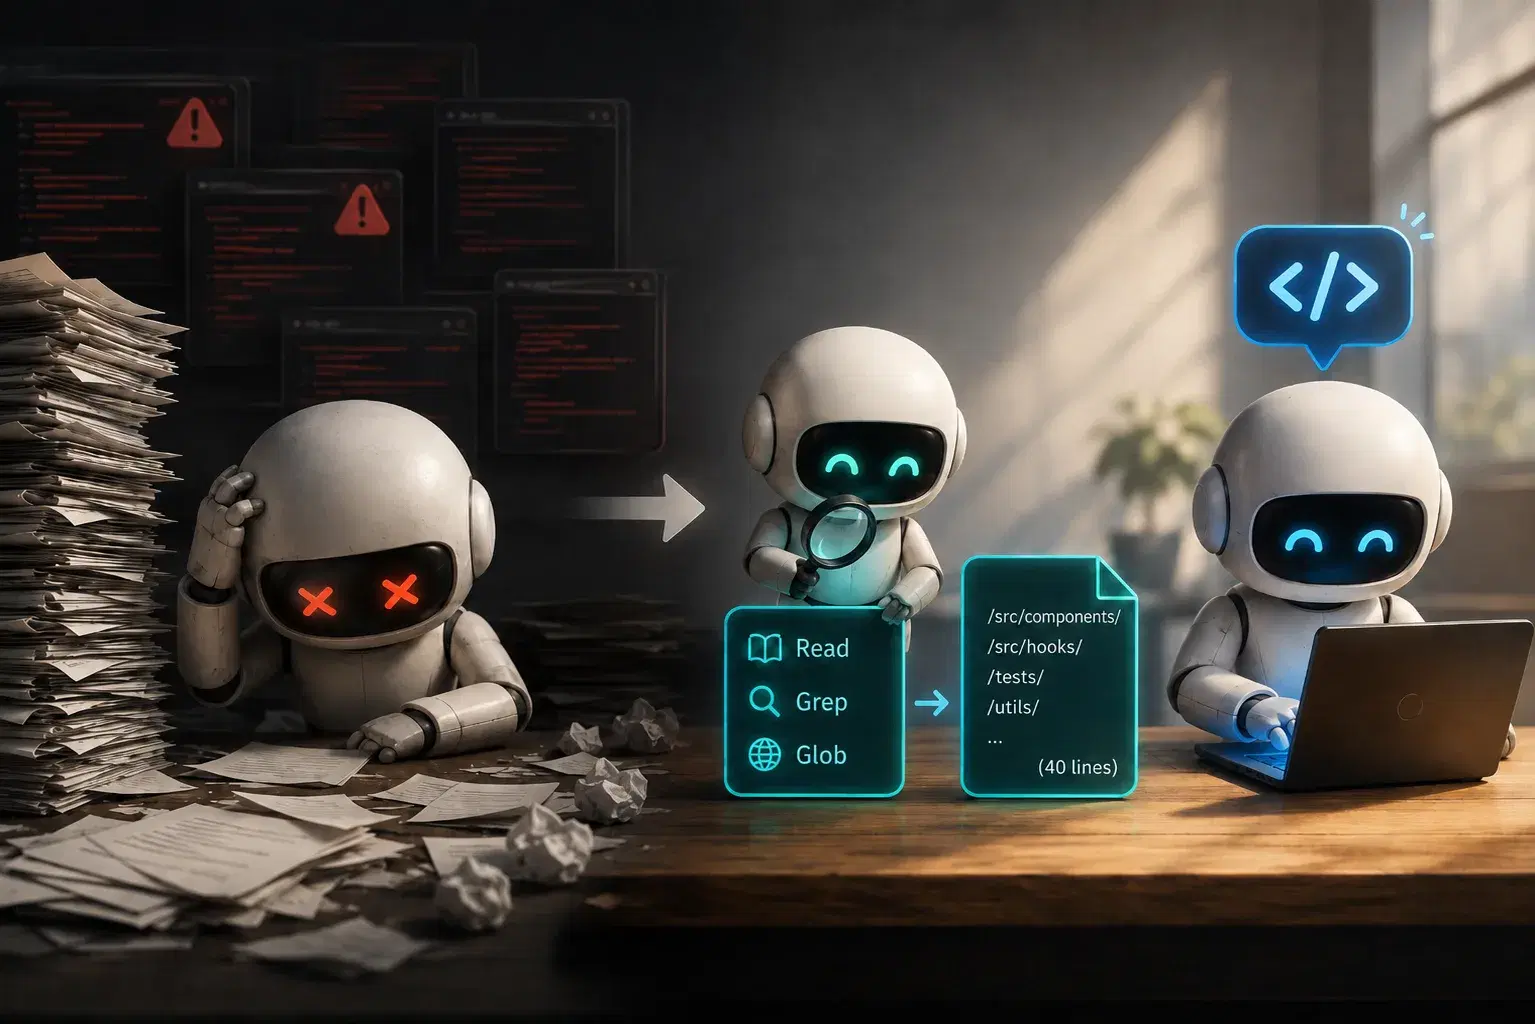
Eksploracja projektu dostała więc własnego subagenta.
I okazało się, że dwie rzeczy są tutaj ważniejsze niż sam wybór modelu.
Trzy narzędzia i wszystkie tylko do odczytu
Read, Grep, Glob.
To nie jest instrukcja w stylu „nie edytuj plików”. To po prostu cały zestaw narzędzi, do których agent ma dostęp.
Nie może zmodyfikować pliku, bo nie ma narzędzia, które pozwala mu to zrobić.
Jest różnica między agentem, któremu powiedzieliśmy, żeby czegoś nie robił, a agentem, który technicznie nie ma takiej możliwości.
Ta różnica zaczyna mieć znaczenie w momencie, kiedy instrukcja zostanie zignorowana.
Twardy limit: czterdzieści linii, ścieżki zamiast kodu
Explorer zwraca informacje o tym, gdzie coś znalazł, ale nie kopiuje fragmentów kodu.
Ma wprost powiedziane, żeby nie cytować zawartości plików.
I właśnie ten drugi warunek daje największy efekt.
Oszczędność pojawiła się gdzie indziej, niż zakładałem
Na początku moje wyjaśnienie było oczywiste.
Tańszy model, tańsze tokeny, niższy koszt.
Tyle że to wyjaśnienie jest błędne. A przynajmniej opisuje najmniej interesującą część całego efektu.
Najważniejsze jest to, że surowe dane z eksploracji nigdy nie trafiają do głównego kontekstu.
Sonnet dostaje czterdziestoliniowe podsumowanie opisujące, gdzie znajdują się potrzebne rzeczy.
Nie dostaje jedenastu plików, które explorer musiał wcześniej otworzyć, żeby przygotować tę odpowiedź.
Główny kontekst pozostaje dzięki temu znacznie czystszy, a sesja wytrzymuje więcej realnej pracy, zanim zacznie tracić jakość.
Dobór modelu wynika więc z rodzaju zadania, a nie odwrotnie.
Haiku jest tam dlatego, że „znajdź mi, gdzie to jest” to przede wszystkim zadanie wyszukiwawcze.
Do takiej pracy nie potrzebuję tego samego modelu, który chwilę później będzie decydował, jak przebudować komponent.
Nawet gdyby oba modele kosztowały dokładnie tyle samo, nadal rozdzieliłbym tę pracę.
Jest też drugi powód, dla którego taki podział jest stosunkowo bezpieczny. Zrozumienie tego zajęło mi trochę więcej czasu.
Koszt błędu podczas eksploracji jest niewielki.
Jeżeli explorer pominie jakiś plik, główny agent znajdzie go później podczas planowania i po prostu go przeczyta.
Najgorszy scenariusz to jedno dodatkowe odczytanie pliku, a nie błędna zmiana w kodzie.
I właśnie ta asymetria sprawia, że delegowanie tego etapu ma sens.
Co mogę powiedzieć, a czego nie
Chcę być tutaj precyzyjny, bo właśnie w tym miejscu podobne wpisy często zaczynają wyciągać zbyt daleko idące wnioski.
Mogę powiedzieć, że moje sesje zauważalnie się wydłużyły i jestem w stanie wykonać więcej realnych zmian, zanim dobiję do limitu.
To jednak obserwacja z kilku tygodni codziennej pracy, a nie pomiar.
Nie uruchamiałem tego samego zadania dwa razy w dwóch różnych konfiguracjach i nie porównywałem liczby tokenów.
Nie mam kontrolowanego testu „przed i po”, a wykresy zużycia, które mógłbym pokazać, i tak nie udowodniłyby tego, co chciałbym nimi udowodnić.
Dlatego traktujcie ten tekst jako opis doświadczenia kogoś, kto zmienił jedną rzecz w swoim workflow i zobaczył poprawę, a nie jako benchmark.
Jeżeli spróbujecie tego podejścia i u was nie zmieni się nic, to też jest wartościowa informacja.
Wolałbym o niej usłyszeć, niż jej nie znać.
Gdzie to podejście się wykłada
Limit czterdziestu linii ustawiłem pod repozytorium z jedną aplikacją.
W dużym monorepo może być po prostu zbyt niski.
Wtedy łatwo dostać niepełny obraz sytuacji przedstawiony z pełnym przekonaniem, a to jest gorsze niż odpowiedź, która otwarcie mówi, że czegoś nie znalazła.
Dlatego zanim uznacie, że samo podejście nie działa, warto najpierw zwiększyć ten limit.
Zasady, których używam razem z tym workflow, mówią też agentowi, żeby trzymał się lokalnych konwencji nawet wtedy, kiedy sam wybrałby inne rozwiązanie.
W projekcie, w którym aktywnie próbujecie odejść od starych wzorców, taka instrukcja będzie działała przeciwko wam.
Zamiast pomagać w zmianie, zacznie utrwalać rzeczy, które właśnie chcecie usunąć.
Do tego mój explorer szuka głównie rzeczy charakterystycznych dla frontendu:
- hooków,
- sposobu składania komponentów,
- stylu importów.
Przy innym stacku tę część trzeba przepisać pod konkretny projekt, a nie kopiować bez zmian.
Jak to jest zrobione
Całość składa się z trzech plików:
- explorera działającego jako subagent,
- skilla zawierającego zasady obowiązujące przy każdej zmianie,
- slash commandu, który uruchamia pięć kolejnych etapów workflow.
Kod jest dostępny na GitHubie na licencji MIT:
github.com/ivansportfolio/claude-code-workflow
Wystarczy skopiować katalog .claude/ do projektu.
Zakładając oczywiście, że wasz CLAUDE.md rzeczywiście zawiera komendy do
lintowania, sprawdzania typów i uruchamiania testów.
Ostatecznie pytanie nigdy nie brzmiało:
Czy mniejszy model jest wystarczająco dobry?
Lepsze pytanie brzmi:
Jak duża część mojej pracy na początku każdego zadania polega po prostu na ustaleniu, gdzie znajdują się potrzebne rzeczy?
I jeżeli mam odpowiedzieć uczciwie, to całkiem spora.
Czy ten wpis był pomocny?