AI Code Review System
Wieloagentowy pipeline do code review merge requestów w GitLabie, który zaprojektowałem i zbudowałem jako własne narzędzie. Wyspecjalizowani agenci równolegle analizują każdą zmianę, a orkiestrator łączy ich ustalenia w jeden uporządkowany raport. Celem jest wskazywanie problemów, na które warto zareagować, i odrzucanie mało wartościowych uwag, zanim trafią do developera.
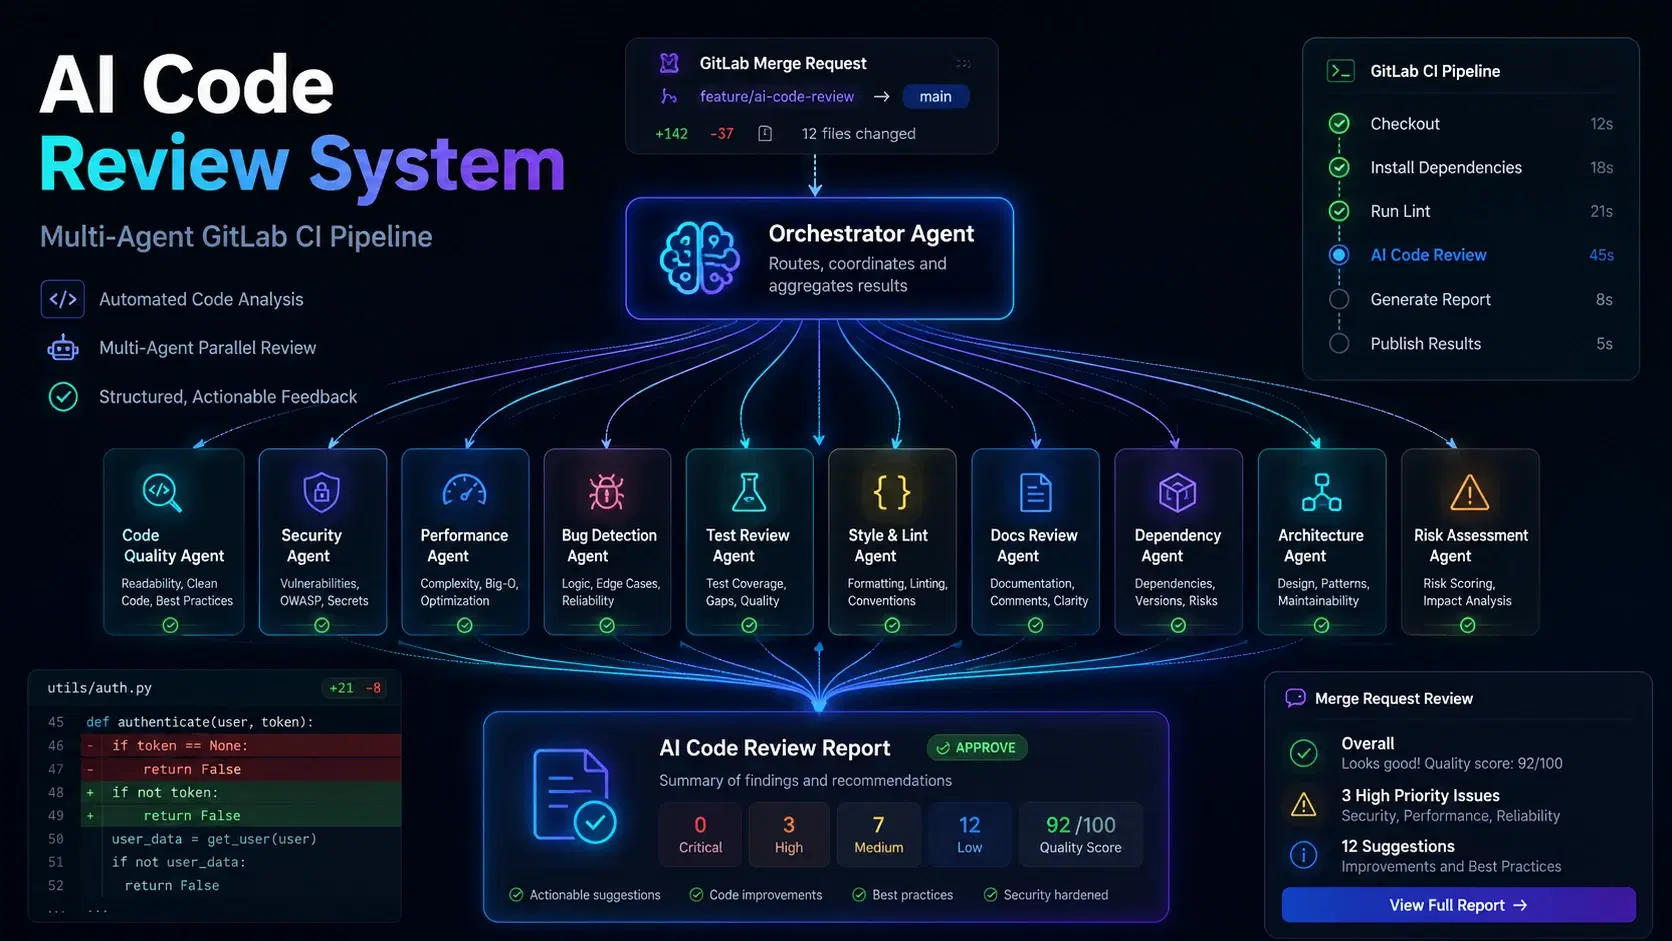
Opis
Problem. Z mojego doświadczenia przeglądy AI oparte na jednym prompcie zwykle dają ogólnikowe lub stylistyczne uwagi, które developerzy uczą się pomijać. Chciałem mieć etap code review dla merge requestów, który zgłasza konkretne problemy poparte dowodami, a poza tym milczy.
Zakładane działanie. Dla każdego merge requestu pipeline pobiera diff, kieruje pliki do wyspecjalizowanych agentów i publikuje jeden uporządkowany komentarz. Każde ustalenie musi cytować zmieniony kod, którego dotyczy.
Zakres. To narzędzie do procesu merge requestów w GitLabie, a nie część wdrożonej aplikacji.
Moja rola
Zaprojektowałem i zbudowałem to narzędzie jako projekt własny. Moja praca obejmowała:
- projekt pipeline'u: orkiestrator i wyspecjalizowani agenci
- prompty każdego agenta oraz przypisany mu model
- bramki jakości i filtr pre-review
- format raportu publikowanego w merge requeście
- kalibrację filtrów w kolejnych cyklach testowych, z ręcznym przeglądem wyników
Technologie
Architektura i decyzje
Orkiestracja. Orkiestrator koordynuje przebieg i sam nie recenzuje kodu. Pobiera diff, kieruje pliki do odpowiednich agentów, zbiera wyniki, usuwa duplikaty i publikuje końcowy raport. Gdy dwóch agentów zgłosi tę samą linię, o wyborze decyduje ustalona kolejność priorytetów, więc wynik nie zależy od przypadku.
Wyspecjalizowani agenci. Dziewięciu agentów analizuje tę samą zmianę, każdy z jednej perspektywy, na przykład bezpieczeństwa, wzorców Reacta czy wydajności. Wybrałem wąskie zakresy, bo krótki, skupiony prompt łatwiej skalibrować i przetestować niż jeden prompt obejmujący wszystko. To decyzja projektowa; nie porównywałem jej z przeglądem opartym na jednym prompcie.
Przydział modeli. W wersji opisanej w artykule sprawdzenia oparte na dopasowywaniu wzorców (typy, style, Storybook) działają na Haiku, sprawdzenia wymagające rozumowania (bezpieczeństwo, złożoność algorytmiczna, architektura) na Sonnet, a orkiestracja na Opus. Celem jest kontrola kosztów: lżejsze modele do prostszych sprawdzeń. Nie mam pomiarów porównujących koszty.
Filtr pre-review. Skrypt powłoki usuwa wygenerowane pliki, pliki lock, vendorowany kod i niezwiązane zmiany, zanim jakikolwiek agent zobaczy diff.
Walidacja ustaleń. Zanim ustalenie zostanie opublikowane, orkiestrator stosuje następujące sprawdzenia:
- Istnienie: oznaczony kod musi występować w diffie, bo agenci potrafią zgłaszać zmiany, których nikt nie wprowadził.
- Dowód: każde ustalenie musi cytować 1-3 linie zmienionego kodu.
- Styl: sugestie wyłącznie stylistyczne są odrzucane.
- Heurystyka językowa: ustalenia sformułowane asekuracyjnie, na przykład ze słowami "might" lub "consider", są odrzucane. To heurystyka usuwająca niepewne uwagi. Samo sformułowanie nie świadczy o poprawności ustalenia, więc może odrzucić trafne uwagi i przepuścić słabe.
Obsługa awarii. Gdy jeden agent zawiedzie, pozostali działają dalej, a raport zawiera dostępne wyniki. Dotyczy to błędów pojedynczego agenta; awaria API, CI lub sieci nadal może przerwać przegląd.
Efekty i ograniczenia
Co istnieje. Działający pipeline złożony z plików promptów w Markdown i skryptu pre-filtra, zaprojektowany do pracy w procesie merge requestów w GitLabie i publikujący jeden uporządkowany komentarz na merge request. Każdy raport oddziela blokery merge od sugestii oraz podaje poziomy ważności i dokładne numery linii.
Co zaobserwowałem. Najwięcej czasu zajęła kalibracja bramek jakości. Zbyt ostre filtry pomijały istotne ustalenia, a zbyt łagodne wpuszczały szum z powrotem. Dostrajałem je w kolejnych cyklach testowych i przy ręcznym przeglądzie wyników. Nie mierzyłem odsetka fałszywych alarmów, oszczędności czasu ani kosztów API, więc nie podaję danych liczbowych.
Ograniczenia. Stosowanie tych samych sprawdzeń do każdego merge requestu daje powtarzalny proces, ale nie mierzyłem jakości przeglądów, a model nadal może pominąć realne problemy lub zgłosić błędne. Raport jest wsparciem dla recenzenta, a nie zgodą na merge; decyzja o merge pozostaje po stronie człowieka.
Zależności. Nie ma własnej aplikacji w Pythonie ani Node.js, ale pipeline wymaga GitLab CI, skryptu powłoki i dostępu do modeli Claude.
Najważniejsze punkty
- Zachowanie zdefiniowane w zwykłych plikach promptów Markdown, które można czytać i zmieniać bez kroku buildowania
- Format raportu zaprojektowany tak, aby developer w kilka sekund widział, co blokuje merge
- Telemetria dla każdego agenta pokazująca, które prompty wymagają poprawek