Model miał dane. A potem pokazał użytkownikowi schemat mojej bazy.
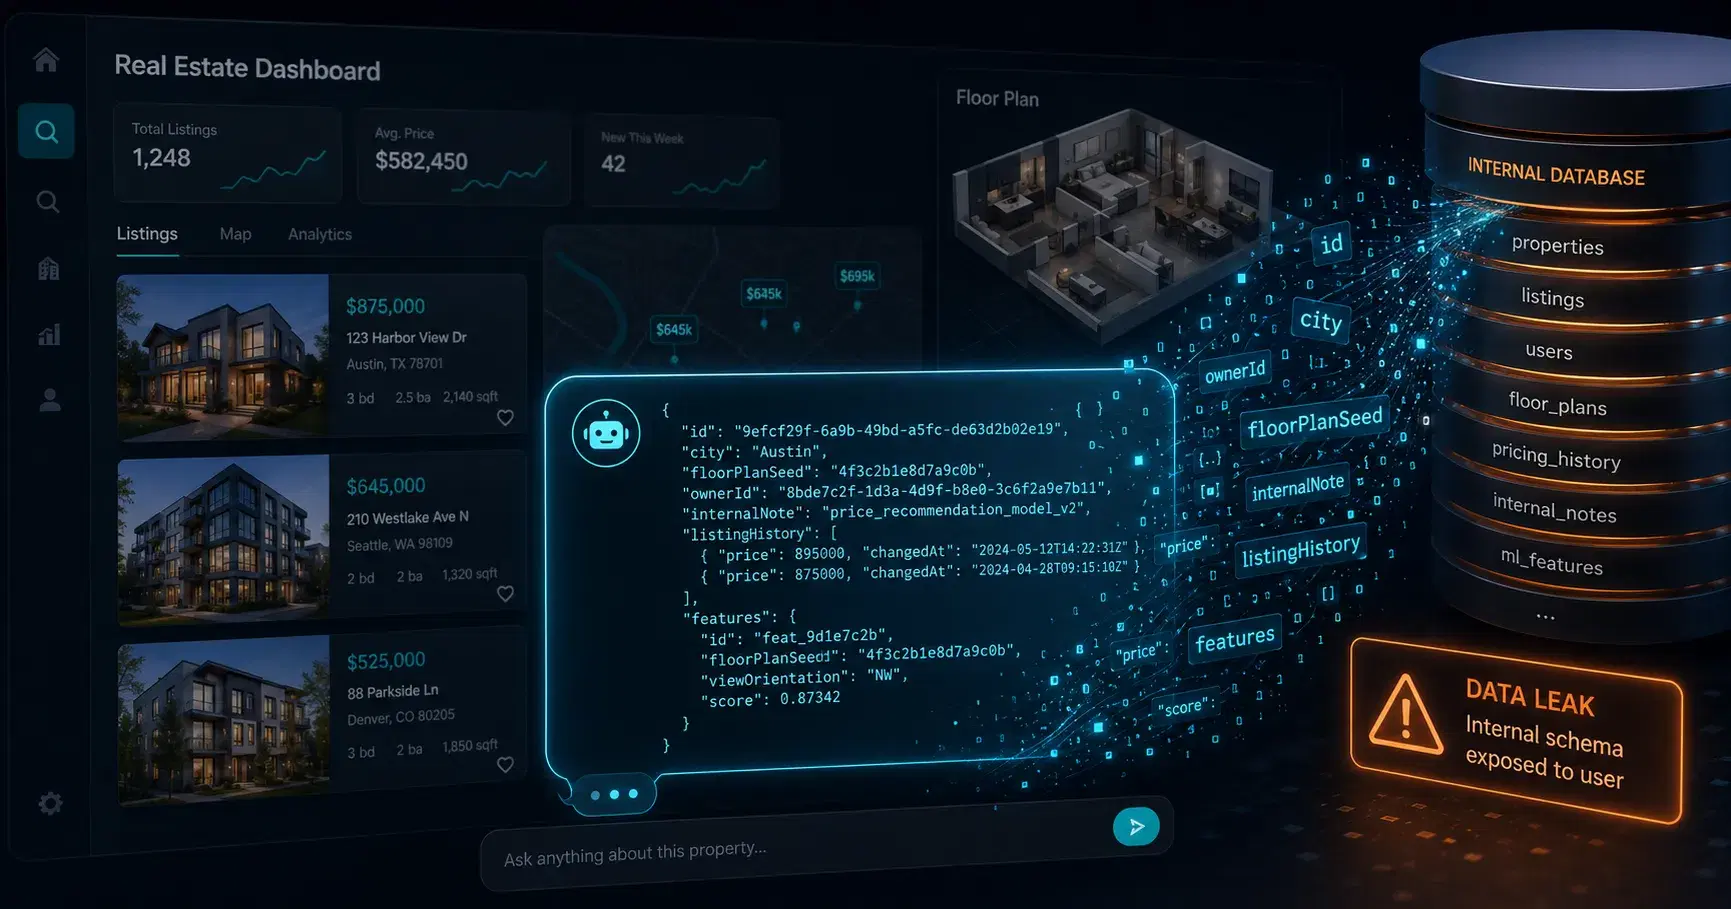
Model miał dane. A potem pokazał użytkownikowi schemat mojej bazy.
Poprosiłem dashboard o znalezienie najtańszej oferty.
Odpowiedział tak:
Proszę sprecyzuj, co chciałbyś zrobić. Czy chcesz zobaczyć ofertę z identyfikatorem '9efcf29f-6a9b-49bd-a5fc-de63d2b02e19', porównać oferty, czy może poszukać nieruchomości w Marki?
Nie cena. Nie adres. UUID.
Wklejony prosto do dymka czatu, w zdaniu, które przy okazji każe mi wybrać jedną z trzech opcji, o które w ogóle nie pytałem.
Pierwszą część tej serii zakończyłem prostym wnioskiem: AI działające na danych ma sens tylko wtedy, kiedy same dane mają sensowny model. Poprawiłem więc generator, opisałem cały problem i przeszedłem do ciekawszej części.
Tym razem dane były w porządku. Problem pojawił się gdzie indziej.
Co zbudowałem
Ten sam projekt co wcześniej. High Water Mark, mały dashboard nieruchomości napisany w React i TypeScript. 50 wygenerowanych ofert, filtry, mapa Polski i trójwymiarowy plan mieszkania dla każdej nieruchomości.
Nowością jest panel czatu po prawej stronie. Ollama działa lokalnie, na modelu
gemma3:4b, a oferty są przekazywane do modelu jako kontekst. Użytkownik pisze
po polsku, czego szuka, a asystent ma przełożyć to na filtry i zastosować je w
aplikacji.
Nic szczególnie egzotycznego. Mniej więcej dokładnie to, co dziś wszyscy doklejają do swoich produktów.
Co działa
Warto to powiedzieć wprost, bo patrząc na zrzut powyżej można odnieść wrażenie, że nie działa nic.
Wyszukiwanie działa. Model znajduje właściwe oferty. Kiedy wpisuję "Mieszkanie 77 m² - Marki", poprawnie zawęża wyniki do jednej nieruchomości, rozumie, że chodzi o mieszkanie o powierzchni 77 m² w Markach, i potrafi na jego temat odpowiedzieć.
Wie też, jaki identyfikator ma rekord, o którym mówi.
I właśnie to ostatnie zdanie jest problemem.
Błąd
W uproszczeniu wysyłałem do modelu coś takiego:
const context = JSON.stringify(listings);

const messages = [
  { role: 'system', content: `Oferty: ${context}` },
  { role: 'user', content: userInput },
];
Dwie linijki. Wyglądają niewinnie. Połowa tutoriali w internecie ma gdzieś podobny fragment.
Problem w tym, że listings to mój wewnętrzny obiekt domenowy. Zawiera
wszystko, czego potrzebuje aplikacja, bo właśnie po to są obiekty domenowe.
type Listing = {
  id: string; // uuid, wewnętrzne
  title: string;
  city: string;
  district: string;
  voivodeship: string;
  type: PropertyType;
  area: number;
  rooms: number;
  price: number;
  pricePerSqm: number;
  status: ListingStatus;
  floorPlanSeed: number; // wewnętrzne, steruje generatorem planu 3D
  createdAt: string;
  // ...
};
Przekazałem modelowi cały ten obiekt i powiedziałem mu, żeby był pomocny.
No więc był.
Kiedy chciał odwołać się do konkretnego rekordu, używał id, bo przecież
właśnie do tego służy pole id. Kiedy chciał zasugerować zmianę filtra, zwracał
użytkownikowi nazwę pola city, bo dokładnie tak nazywało się ono w danych.
Model nie zrobił żadnego wycieku. Po prostu powtórzył to, co sam mu przekazałem. To nie jest błąd gemmy.
Błąd polegał na tym, że nigdy nie zdecydowałem, co model w ogóle powinien wiedzieć.
Dlaczego to nie jest tylko problem kosmetyczny
W moim projekcie najgorszy możliwy scenariusz to trochę wstydu. Mockowe dane, UUID, nazwa pola. Brzydko wygląda, ale tyle.
Teraz przenieśmy dokładnie ten sam mechanizm do prawdziwego produktu.
Twój typ Listing nie kończy się przecież na cenie i metrażu. Ma
internalNotes. Ma ownerPhone. Ma commissionRate, acquisitionCost,
sellerMotivation, minimumAcceptedPrice. Dwa sprinty temu ktoś dorzucił
tablicę flags i dziś nikt już dokładnie nie pamięta, co w niej siedzi.
Potem ktoś pisze JSON.stringify(listings) i wrzuca wynik do promptu
systemowego, bo to najszybszy sposób, żeby demo zaczęło działać. I nagle
minimalna cena, którą sprzedający jest gotów zaakceptować, znajduje się jedno
niezręcznie zadane pytanie od kupującego.
Nic w twoim stacku tego nie zatrzyma. TypeScript nie pomoże, bo typ jest poprawny. Linter też nie. Code review prawdopodobnie również nie, bo diff ma dwie linijki i obie wyglądają jak zwykłe techniczne podłączenie danych.
Najgorsze jest to, że nic nie wybuchnie. Całość będzie działać świetnie. Aż do momentu, kiedy model powie coś, czego nigdy nie powinien był powiedzieć.
Rozwiązanie
Pierwszy odruch jest prosty: usuń złe pola. Przed wysłaniem skasuj id. Usuń
floorPlanSeed. Gotowe.
Tyle że to jest blocklista, a blocklisty mają jedną paskudną cechę: starzeją
się. Osoba, która za pół roku doda nowe pole do Listing, może nawet nie
wiedzieć, że gdzieś istnieje prompt oparty na tym obiekcie. Dochodzi nowa
wrażliwa kolumna, nikt nie aktualizuje listy pól do usunięcia, i problem wraca.
Dlatego zrobiłem odwrotnie: osobny typ opisujący dokładnie to, co model może zobaczyć, plus mapper, który ten obiekt buduje.
// Wszystko, co model może zobaczyć.
// Dla niego nic poza tym nie istnieje.
type ListingForModel = {
  ref: string; // krótki, czytelny identyfikator zamiast uuid
  title: string;
  city: string;
  type: string;
  area: number;
  rooms: number;
  price: number;
  pricePerSqm: number;
  status: string;
};

function toModelView(listing: Listing, index: number): ListingForModel {
  return {
    ref: `#${index + 1}`,
    title: listing.title,
    city: listing.city,
    type: labelFor(listing.type),
    area: listing.area,
    rooms: listing.rooms,
    price: listing.price,
    pricePerSqm: listing.pricePerSqm,
    status: labelFor(listing.status),
  };
}
Zmieniły się trzy rzeczy i tylko jedna z nich dotyczy bezpośrednio bezpieczeństwa.
Allowlista zamiast blocklisty. Nowe pola dodane do Listing nie trafiają
automatycznie do modelu. Pojawią się tam dopiero wtedy, kiedy ktoś świadomie
doda je również do ListingForModel. To mały plik, którego jedynym zadaniem
jest odpowiedzieć na pytanie: co model może zobaczyć? Dodanie nowego pola staje
się decyzją, a nie efektem ubocznym.
Pole ref. Model nadal musi mieć możliwość wskazania konkretnej oferty.
Dostaje więc identyfikator, tylko nie klucz główny z bazy. #7 jest czymś, co
człowiek może zobaczyć, zapamiętać albo przeczytać na głos. UUID zostaje po
mojej stronie, w mapie łączącej ref z prawdziwym id.
Etykiety zamiast surowych wartości enumów. labelFor(status) zamienia
SOLD na "Sprzedane". Model bardzo chętnie używa słownictwa, które mu podasz,
więc warto podawać mu dokładnie to samo słownictwo, które użytkownik widzi już w
interfejsie. Jeżeli model używa innych nazw niż UI, to w praktyce zbudowałeś dwa
różne produkty.
Ten ostatni punkt może wyglądać jak detal. Tak naprawdę zawiera w sobie całą ideę. Kontekst modelu powinien być traktowany jak warstwa prezentacji dla użytkownika, a nie jak dump danych. Trzeba go projektować tak samo świadomie jak tekst w interfejsie.
Wzorzec, który kryje się pod spodem
Pierwsza część była o generatorze danych, który losował każde pole niezależnie. Każda wartość z osobna wyglądała wiarygodnie, ale relacje między nimi nie miały żadnego sensu.
Tutaj zrobiłem właściwie ten sam błąd. Tylko piętro wyżej.
Naprawiłem warstwę, na którą akurat patrzyłem, i nie zadałem sobie pytania, co znajduje się nad nią. Tak bardzo skupiałem się na tym, czy dane mają sensowny model, że nie zastanowiłem się, co te dane w ogóle mogą powiedzieć użytkownikowi. A kiedy LLM odpowiedział, zrobił to językiem mojej bazy danych. Bo był to jedyny język, jaki mu dałem.
Na każdej warstwie ktoś musi zdecydować, co może zostać wystawione dalej. Baza danych do API. API do klienta. Klient do użytkownika. W tych miejscach mamy już dziesiątki lat wypracowanych nawyków: DTO, serializery, view modele, schematy odpowiedzi. Nikt rozsądny nie wystawia dziś endpointu REST, który po prostu zwraca surowy rekord z bazy.
A potem pojawiły się LLM-y i w jedno popołudnie wszyscy wróciliśmy do
JSON.stringify(everything).
Podobny mechanizm opisywałem zresztą w poprzednim wpisie o plikach konfiguracyjnych agentów, których nikt nie reviewuje. Ten sam schemat. Powstaje nowa powierzchnia, która może mieć realne konsekwencje, ale znajduje się poza miejscami, które nauczyliśmy się dokładnie sprawdzać.
Co nadal nie działa
Tak jak poprzednio, nie zamierzam naprawiać wszystkiego przed napisaniem kolejnego tekstu.
Asystent wciąż właściwie niczego nie robi. Każda odpowiedź kończy się prośbą o doprecyzowanie. Doprecyzowujesz, dostajesz kolejne pytanie. Na pytanie o preferencje odpowiedziałem po prostu "nie", a model w odpowiedzi zaproponował mi trzy nowe opcje. Filtry na górze dashboardu nie zmieniają się w ogóle, niezależnie od tego, co czat twierdzi, że właśnie robi.
Czyli na ten moment asystent rozumie użytkownika, a potem kompletnie nic z tym nie robi. I szczerze mówiąc, to jest nawet ciekawsza awaria niż UUID pojawiający się w czacie. O tym będzie część 3.
Najmniej wygodne podsumowanie tej części jest proste: problemem nigdy nie był model. Problemem był mój kontekst.
Część 1: Mój dashboard zbudowany z AI wyglądał świetnie. Dopóki nie przeczytałem własnych danych.
Czy ten wpis był pomocny?