Mój dashboard zbudowany z pomocą AI wyglądał świetnie. Potem przeczytałem własne dane.
Dwa dni pracy z AI dały mi działający dashboard nieruchomości w 3D. Każde pole wyglądało wiarygodnie. Oferty nie miały sensu. Część 1 serii o budowaniu z AI zamiast tylko recenzowania.
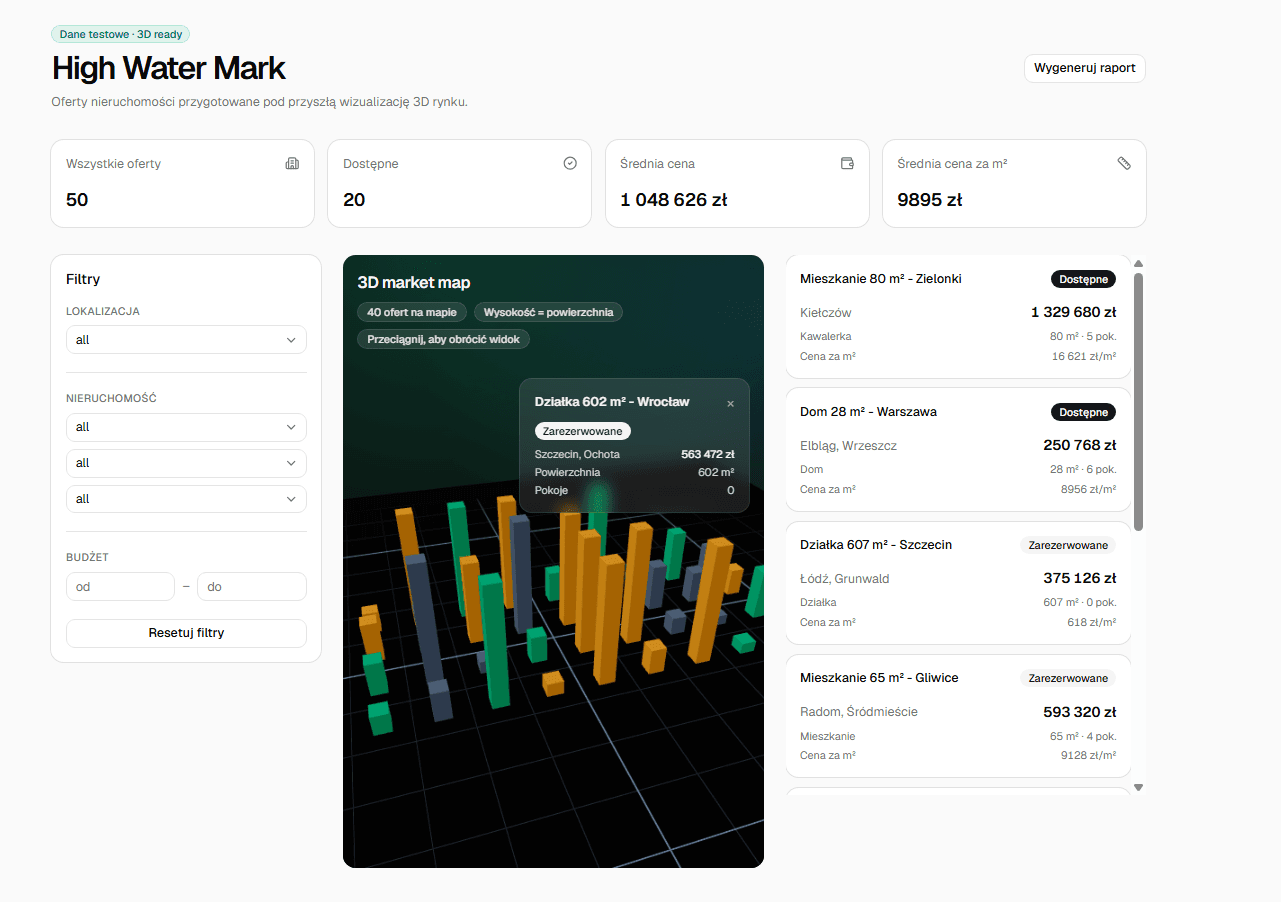
Zbudowałem to w dwa dni z pomocą AI.
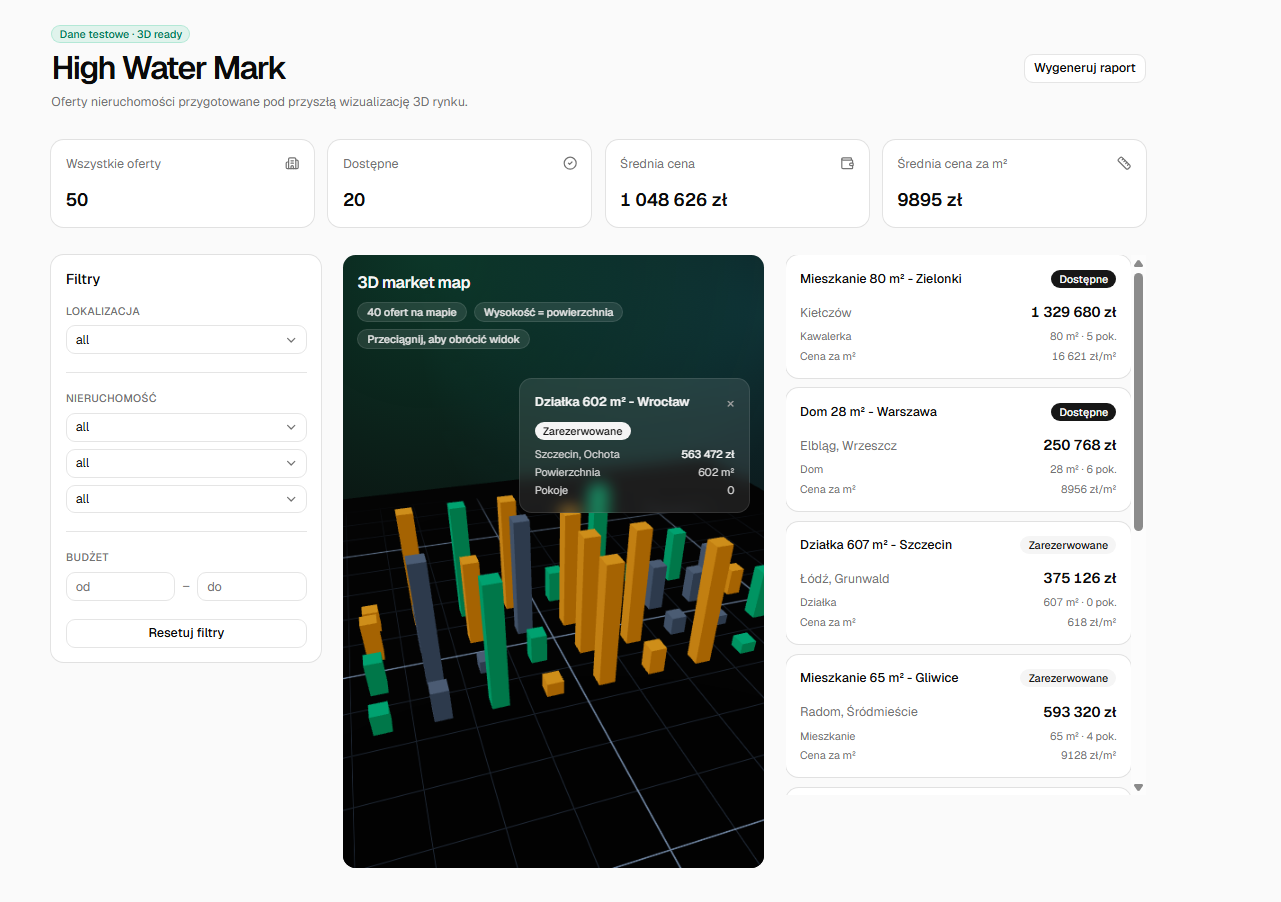
Zanim przewiniesz dalej, spróbuj znaleźć trzy błędy na tym zrzucie ekranu.
Sam ich nie znalazłem. Sprawdzałem, czy dashboard wygląda wystarczająco dobrze: kąt kamery, odstępy, etykiety, kolory. Potem wkleiłem zrzut ekranu do czatu z AI, żeby omówić wpis na jego temat. AI przeczytało moje dane uważniej niż ja.
Oto lista:
- Dom o powierzchni 28 m² z 6 pokojami.
- Oferta zatytułowana "Wrocław" z lokalizacją "Szczecin, Ochota". Ochota to dzielnica Warszawy.
- Kawalerka 80 m² z 5 pokojami.
Każde pole z osobna wygląda wiarygodnie. Razem oferty nie mają sensu. I prawie opublikowałem post o tym dashboardzie, nie zauważając tego.
Co zbudowałem w dwa dni
Mały projekt poboczny: High Water Mark, dashboard nieruchomości. React, TypeScript, Vite, shadcn/ui i scena Three.js, w której każda oferta to słupek na siatce. Wysokość pokazuje powierzchnię, kolor pokazuje status. Możesz obracać widok, najechać na słupek i kliknąć, żeby zobaczyć szczegóły.
Dane pochodzą z faker-js: 50 wygenerowanych ofert z polskimi miastami, dzielnicami i cenami w PLN. Statystyki liczone są na żywo. Całość zajęła dwa dni pracy z AI. Większość tego czasu poszła na scenę 3D i layout.
Tempo było prawdziwe. Ta część obietnicy AI działa.
Ale tempo ma zabawny efekt uboczny: sprawia, że zaczynasz ufać czemuś szybciej, niż powinieneś.
Skąd bierze się błąd
Oto oryginalny generator, uproszczony:
// title: losuje miasto, niezależnie od location
const title = `${typeLabel} ${area} m² - ${faker.helpers.arrayElement(cities)}`;

// location: losuje miasto ponownie, dzielnica ze WSPÓLNEJ puli
const location = {
  city: faker.helpers.arrayElement(cities),
  district: faker.helpers.arrayElement(allDistricts),
};

// type, area i rooms: trzy niezależne losowania
const type = faker.helpers.arrayElement(types);
const area = faker.number.int({ min: 25, max: 220 });
const rooms = faker.number.int({ min: 0, max: 6 });
Każda linia sama w sobie jest w porządku. Każda wartość jest wiarygodna. Miasto z prawdziwej listy miast. Dzielnica z prawdziwej listy dzielnic. Powierzchnia w sensownym zakresie.
Problem: nic ich nie łączy. Tytuł losuje własne miasto. Dzielnica nie wie, do jakiego miasta należy. "Dom" nie wie, że nie powinien mieć 28 m². "Kawalerka" nie wie, że nie może mieć 5 pokoi.
Lokalnie poprawne, globalnie bez sensu
To ten sam schemat błędu, o którym ciągle piszę w kontekście kodu generowanego przez AI.
Zmyślone wywołanie funkcji wygląda dobrze. Import wygląda dobrze. Nazwy wyglądają dobrze. Każdy fragment przechodzi szybki rzut oka, bo każdy fragment sam w sobie jest wiarygodny. Problem siedzi w relacjach między fragmentami. I dokładnie tam zmęczony reviewer nie patrzy.
Mój generator zrobił to samo z danymi. I zabawne jest to, że nie byłem ślepy na błędy. Aktywnie ich szukałem. Tylko nie tych.
Sprawdzałem interakcje, layout, stany hover, czy słupki są czytelne, czy UI nie wygląda zbyt zabawkowo. Recenzowałem to jako interfejs, nie jako zbiór danych. I właśnie tam dane mnie oszukały.
Niewygodna część: to nie był czyjś pull request. To był mój własny projekt, moje własne dwa dni i mój własny zrzut ekranu. Miałem to opublikować jako "zobaczcie, co potrafi zbudować AI".
Naprawa: losuj przyczyny, wyprowadzaj skutki
Pierwszym instynktem było załatać oczywiste przypadki. Nie pozwalaj na 6-pokojowe kawalerki. Nie losuj dzielnic Warszawy dla Szczecina. Nie twórz maleńkich domów.
Ale to tylko ukryłoby ten sam błąd w trzech miejscach. Prawdziwym problemem nie była jedna zła wartość. Problemem był sposób, w jaki generator był zbudowany.
Więc zamiast losować każde pole niezależnie, losuję przyczyny i wyprowadzam skutki:
// 1. Najpierw miasto, dzielnica tylko z dzielnic TEGO miasta
const city = faker.helpers.arrayElement(cities);
const district = faker.helpers.arrayElement(districtsByCity[city]);

// 2. Najpierw typ, potem area i rooms w granicach tego typu
const type = faker.helpers.arrayElement(types);
const { minArea, maxArea } = areaRangeFor(type); // kawalerka: 18-35, dom: 70-250...
const area = faker.number.int({ min: minArea, max: maxArea });
const rooms = roomsFor(type, area); // ~1 pokój na 20-25 m², działka: 0

// 3. Tytuł wyprowadzony z danych, które już istnieją. Nigdy nie losowany ponownie.
const title = `${typeLabel(type)} ${area} m² - ${city}`;
Zależności idą w jedną stronę. Lokalizacja decyduje o dzielnicy. Typ decyduje o zakresie powierzchni. Powierzchnia decyduje o liczbie pokoi. Tytuł jest po prostu budowany z pól, które już istnieją. Nic nie jest losowane dwa razy.
Efekt:
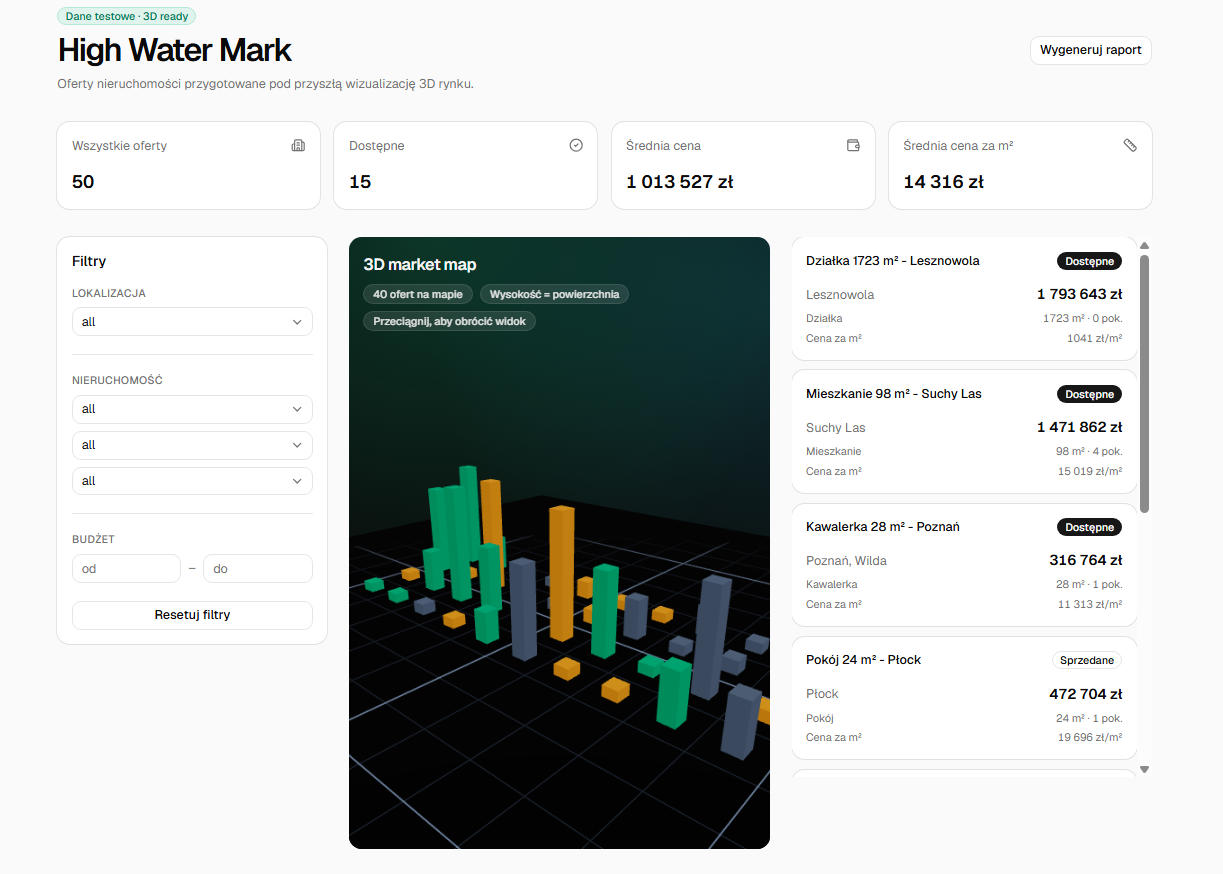
Oferta 28 m² to teraz kawalerka z 1 pokojem. Wilda faktycznie leży w Poznaniu. Działki mają zero pokoi. Dane w końcu zaczęły wyglądać jak dane.
Co wciąż jest nie tak
Szczerze mówiąc, naprawa nie objęła wszystkiego:
- Pokój 24 m² wyceniony na 472 704 zł. Pokoje prawdopodobnie w ogóle nie powinny być typem "na sprzedaż".
- Mieszkanie na wsi wycenione jak w centrum Warszawy. Ceny całkowicie ignorują lokalizację.
Zostawiam to na razie celowo. Spójność danych to nie jedna poprawka. To zbiór zależności, który ciągle rozszerzasz. Cena powinna zależeć od lokalizacji. Każda nowa zależność sprawia, że dane są bardziej realne, a generator mniej losowy.
I to cała lekcja w jednym zdaniu: realistyczne dane to nie losowe wartości w realistycznych zakresach. To relacje.
Co dalej
Część 2 to powód, dla którego ten projekt w ogóle istnieje: chatbot AI na tych danych. "Porozmawiaj ze swoimi ofertami" zamiast klikania filtrów.
To też powód, dla którego chciałem naprawić dane przed dodaniem chatbota. Jeśli dane mówią, że dom ma 28 m², a dzielnica Warszawy należy do Szczecina, chatbot mnie nie uratuje. Tylko ułatwi pytanie o te bzdury.
I prawdopodobnie zrobi to bardziej przekonująco.
AI pracujące na danych działa tylko wtedy, gdy dane mają model. Więcej o tym wkrótce.
Czy ten wpis był pomocny?